この知恵で考えられること
生成AIやLLMを業務へ導入するとき、評価の失敗は「数字を間違えること」だけではない。
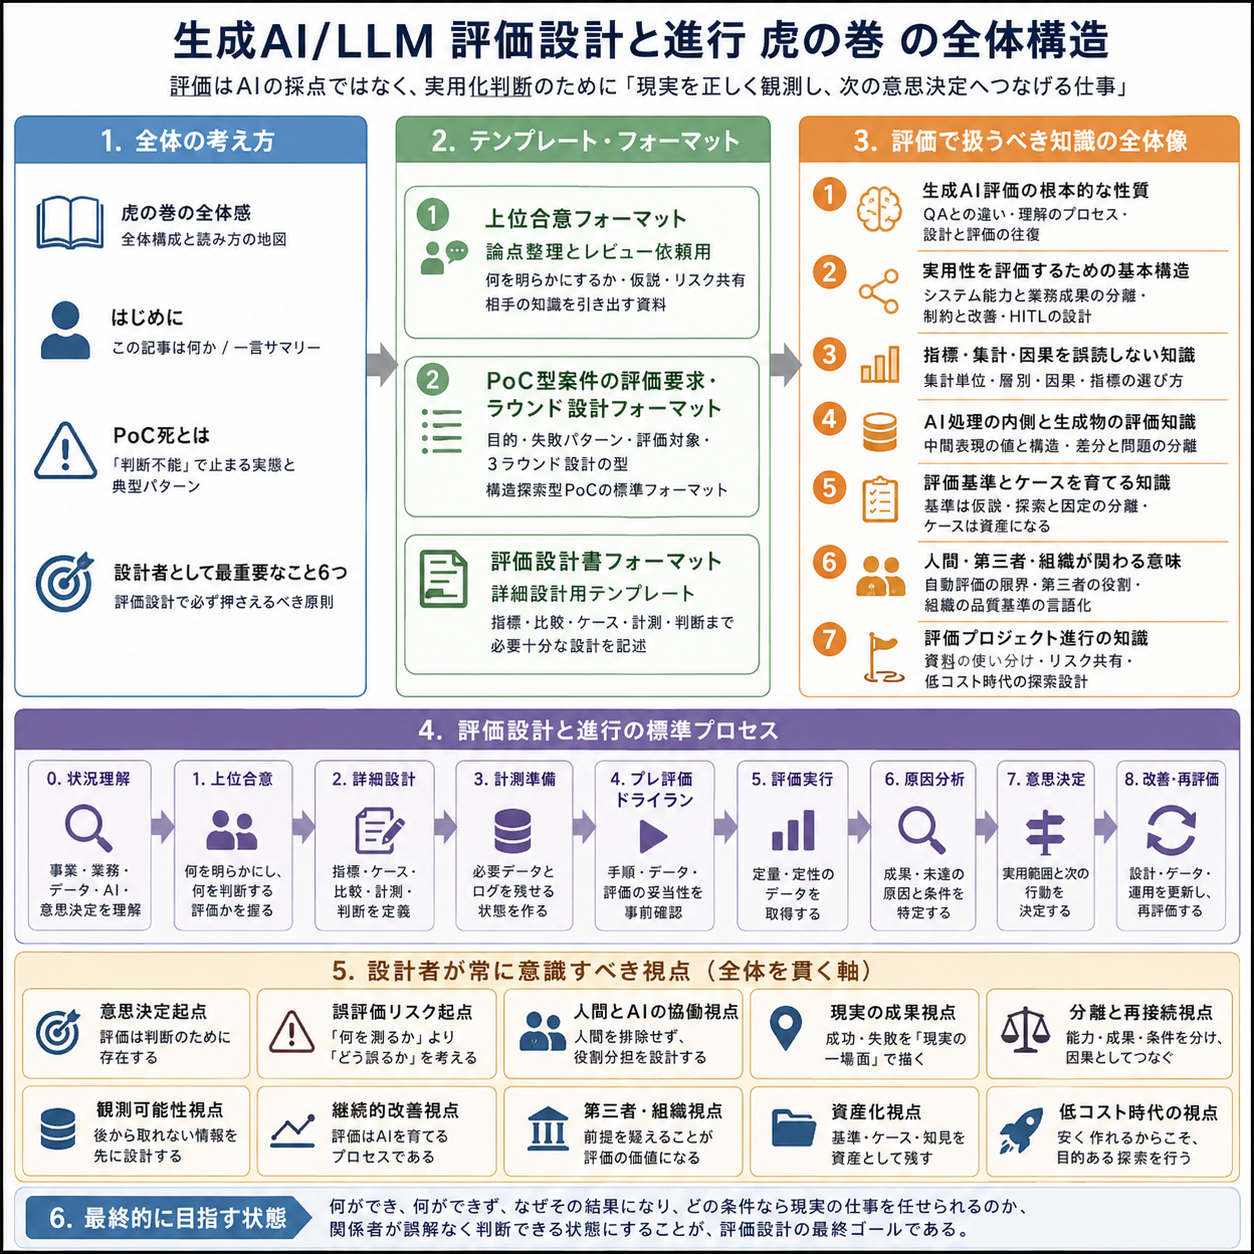
虎の巻の全体感
どんな内容がこのnotionに書いてあるかの全体感です。
はじめに
この記事は何か
生成AIやLLMを業務へ導入するとき、評価の失敗は「数字を間違えること」だけではない。
精度を正確に測ったのに、実用性を誤って判断する。業務成果が出たのに、AIの効果だと説明できない。PoCでは動いたのに、本番で再現しない。大量のKPIを取得したのに、継続・改善・限定導入・停止のどれを選ぶべきか分からない。
こうした失敗は、モデルの性能不足ではなく、評価対象、比較方法、集計単位、現場運用、観測方法、意思決定との接続が曖昧なことによって起こる。
本書は、生成AI/LLMの評価を「採点」ではなく、実用化に必要な事実を誤解なく明らかにし、次の意思決定へ接続する仕事として捉えるための知識とフォーマットをまとめたものである。
一言サマリー
生成AI/LLMの評価設計とは、AIに点数をつけることではない。AI、人間、既存システムが混ざった業務の現実を誤解なく観測し、どの条件なら何を任せられるのかと、次にどの意思決定を行うのかを定める仕事である。
評価設計では、少なくとも以下を扱う必要がある。
- 何が起これば、事業や業務が良くなったと言えるのか
- 何が一度でも起これば、他の成果にかかわらず実用化できないのか
- AIそのものの能力と、AIを含む業務全体の成果をどう分けるか
- 人間の利用、修正、例外処理による影響をどう切り分けるか
- 全体平均の裏にある、成功条件と失敗条件をどう特定するか
- AIを使わない現実的な代替案と比べ、AIを使う意味があるか
- テスト後には復元できない情報を、事前にどう残すか
- 結果ごとに、継続、改善、限定導入、拡大、停止のどれを選ぶか
評価設計とは何を定める行為なのか
評価設計は、KPIを考えるところから始まるものではない。実務上は、次の順序で構成される。
意思決定
何を判断できるようにするのか
    ↓
成功・失敗の現実
何が変われば価値があり、何が起きれば失敗なのか
    ↓
制約・Gate
成果にかかわらず守らなければならない条件は何か
    ↓
評価対象
AI、人間、データ、既存システム、業務のどこまでを見るか
    ↓
明らかにする事実
システム能力、業務成果、実用範囲、原因をどう捉えるか
    ↓
誤評価リスク
どのような場合に、正しい数字から誤った結論が生まれるか
    ↓
比較・ケース・集計単位
何と比べ、どの対象を、どの粒度で見るか
    ↓
指標・計測
何を、いつ、どのデータから取得するか
    ↓
判断ロジック
どの結果なら、どの意思決定を行うか
    ↓
最終報告
何ができ、何ができず、どこまで使えるかを説明する
このどこかが欠けると、評価は実行できても、結果の意味を説明できなくなる。
PoC死とは
PoC死は「技術的失敗」ではなく「判断不能」として起こる
採用面接では、不採用は「能力がない」と証明された場合だけに起きるわけではない。「能力があると言い切れない」場合にも不採用になる。
PoCも同じである。精度が悪かったから止まるだけではない。一部では成果が出ている。致命的な問題も見つかっていない。しかし、次の投資をしてよいと言い切れない。どこまでなら使えるか分からない。成果の原因が説明できない。こうした判断不能な状態でもプロジェクトは止まる。
PoC死の典型
- システム能力は測ったが、業務成果を測っていない
- 業務成果は出たが、AIの寄与を説明できない
- 全体平均は良いが、失敗条件が分からない
- PoC期間特有の運用と本番運用を区別していない
- AIを使わない簡易な方法との違いが分からない
- 問題がAI、データ、UI、運用のどこにあるか分からない
- 当初KPIを達成したが、経営判断に必要な問いへ答えていない
PoCで本当に避けるべき状態
PoCで本当に避けるべき状態は、「失敗」という明確な結論ではない。
良いとも悪いとも言い切れず、次の行動が決まらない状態である。
設計者として最重要なこと6つ
これがインストールされていない場合に結果的に自走できなくなる・進行品質が落ちる。
1. 「何を測るか」より先に「何を判断するための評価か」を定める
評価の最終目的は数値を出すことではない。
評価終了後に、
- 継続する
- 拡大する
- 限定導入する
- 改善して再評価する
- 別方式へ変更する
- 停止する
といった意思決定ができる状態をつくることである。
したがって設計者は、「この数字が良かったら何を決められるのか」を常に問う。
その答えがなければ、その指標は評価上重要ではない可能性がある。
2. AIの失敗だけでなく「評価そのものが失敗するパターン」を考える
AI評価では、AIの性能だけが誤りを生むわけではない。
- 人がAIを使わなかった
- 人がAIを補正した
- 簡単なケースだけ評価した
- 真値が不正確だった
- 比較条件が違った
- 全体平均で原因が消えた
- テスト期間だけ特別運用になった
といった理由で、AIを過大評価・過小評価することがある。
設計者は、「どのようにすれば間違った結論が生まれるか」をKPI設計より先に考える。
3. 評価を採点工程ではなく、理解と意思決定を更新するプロセスとして設計する
生成AIの評価では、評価によって初めて分かることが多い。
- 品質を構成する要素
- 人間が無意識に使っていた判断基準
- AIが苦手な条件
- 本当に必要な精度
- AIと人間の適切な役割分担
- 実用可能範囲
評価結果によって設計そのものが変わる。
そのため、生成AIにおける評価はリリース直前の検査だけではない。
設計、実装、評価、原因分析、改善を往復しながら能力と運用を形にするプロセスである。
4. 成功と失敗を、システムではなく現実の一場面として描く
評価設計の起点は、精度目標でもテストケースでもない。この取り組みが成功したとき、現実で誰の仕事がどのように変わっているかを描くことである。
「業務を効率化する」「問い合わせ品質を上げる」「問題を早期発見する」という言葉だけでは、必要な能力を定義できない。
成功した一場面として、次のような状態まで描く必要がある。
- 誰の画面やチャットに、いつ、何が表示されるのか
- その人は何を確認し、何を判断するのか
- それまで行っていた何をしなくてよくなるのか
- その結果、何の速度、品質、コスト、安全性が変わるのか
- 例外が発生したとき、誰がどのように処理するのか
同時に、「予定していたものはすべて完成した。それでも成果は出なかった。なぜか」という失敗像を描く。
この問いを置くと、精度は高いが使われない、時間は減ったが再利用できない、紹介文は良くなったが顧客は読んでいない、検知件数は増えたが人間確認が増えた、といった暗黙の失敗条件が見える。
成功像と失敗像の差分に、評価で確認すべき事実がある。
5. システム能力、業務成果、解釈条件を分け、因果として再接続する
生成AIの評価では、少なくとも三種類の情報を分ける必要がある。
| 種類 | 主語 | 例 |
|---|---|---|
| システム能力 | AI・システム | 正解率、Recall、検索精度、誤差、処理時間、制約違反 |
| 業務成果 | AIを含む業務全体 | 工数、処理量、売上、顧客対応品質、事故、配送効率 |
| 解釈・フィルタリング情報 | 人・条件・運用 | AI指示との一致度、上書き、担当者属性、ケース難易度、データ条件 |
システム能力だけでは、実用価値が分からない。業務成果だけでは、なぜその結果になったか分からない。解釈情報がなければ、両者の因果を誤認する。
例えば全体の生産性が5%改善していても、AIに従った人は悪化し、AIに従わなかった人だけ改善している可能性がある。逆に、AIに従ったケースだけ改善しているなら、AIの寄与を説明しやすい。
評価設計者に必要なのは、三種類の数字を並べることではない。どのシステム能力が、どの条件で、どの人間行動を通じて、どの業務成果へ接続したのかを説明できる構造を作ることである。
6. 観測可能性と判断分岐を、テスト開始前に仕込む
評価に必要な情報の多くは、テスト終了後に作れない。
- AIが最初に何を出力したか
- どのバージョンのモデルやプロンプトだったか
- 人間が何を変更したか
- 変更前後の差は何か
- なぜ変更したか
- 最終的に何が実行されたか
- その結果、何が起きたか
- 正解として使った値は実測か推定か
これらは、実行前にログ、UI、観察、ヒアリング、データ連携を設計しなければ失われる。
さらに、結果と判断の対応も先に置く必要がある。
- 成果も再現性もあるなら実用化する
- 一部条件だけなら限定導入する
- システム能力はあるが成果が出ないなら運用やUIを改善する
- システム能力が不足しているならAIを改善する
- AIと簡易ロジックに差がないならAIである必要性を見直す
- データ不足で結論が出ないなら追加評価する
- 致命条件に抵触したなら、その条件を実用範囲から除外する
数字が出た後に判断基準を作ると、結果に合わせて解釈が動く。評価の信頼性は、分析技術だけでなく、事前に何を観測し、どう判断するかを決めたかによって成立する。
テンプレ・フォーマット
評価プロジェクトの標準的な進行プロセス
| フェーズ | 主な目的 | 主な成果物 | この段階で起きやすい失敗 |
|---|---|---|---|
| 0. 状況理解 | 事業、業務、AI、人、データ、意思決定を理解する | 情報収集メモ、業務状態、制約、仮説 | 既存資料だけで理解したつもりになる |
| 1. 上位合意 | 何を明らかにし、何を判断する評価かを握る | 評価方針・主要論点レビュー | 詳細KPIを出しすぎて相手の思考を止める |
| 2. 詳細設計 | 比較、指標、ケース、母集団、計測、判断を定義する | 評価設計書 | 測りやすい指標へ引っ張られる |
| 3. 計測準備 | 必要なログとデータを残せる状態にする | ログ仕様、データ辞書、実行手順 | 後から取れない情報に気づかない |
| 4. プレ評価・ドライラン | 評価手順とデータ取得が機能するか確かめる | 初期結果、欠損、評価者間差 | 本番開始後に計測不能が発覚する |
| 5. 評価実行 | 定量・定性のデータを取得する | 評価結果、事例、観察記録 | 数字だけ集め、理由を残さない |
| 6. 原因分析 | 成果・未達の原因と条件を特定する | 成功条件、失敗条件、改善仮説 | 全体平均で終わる |
| 7. 意思決定 | 実用範囲と次の行動を決める | 最終レポート、判断、残存リスク | 「概ね良好」で終わる |
| 8. 改善・再評価 | 設計、データ、運用を更新する | 改善版、再評価計画 | 同じKPIだけを繰り返す |
md版
0. 状況理解
主な目的
- 事業、業務、AI、人、データ、意思決定を理解する
主な成果物
- 情報収集メモ
- 業務状態
- 制約
- 仮説
この段階で起きやすい失敗
- 既存資料だけで理解したつもりになる
1. 上位合意
主な目的
- 何を明らかにし、何を判断する評価かを握る
主な成果物
- 評価方針
- 主要論点レビュー
この段階で起きやすい失敗
- 詳細KPIを出しすぎて相手の思考を止める
2. 詳細設計
主な目的
- 比較、指標、ケース、母集団、計測、判断を定義する
主な成果物
- 評価設計書
この段階で起きやすい失敗
- 測りやすい指標へ引っ張られる
3. 計測準備
主な目的
- 必要なログとデータを残せる状態にする
主な成果物
- ログ仕様
- データ辞書
- 実行手順
この段階で起きやすい失敗
- 後から取れない情報に気づかない
4. プレ評価・ドライラン
主な目的
- 評価手順とデータ取得が機能するか確かめる
主な成果物
- 初期結果
- 欠損
- 評価者間差
この段階で起きやすい失敗
- 本番開始後に計測不能が発覚する
5. 評価実行
主な目的
- 定量・定性のデータを取得する
主な成果物
- 評価結果
- 事例
- 観察記録
この段階で起きやすい失敗
- 数字だけ集め、理由を残さない
6. 原因分析
主な目的
- 成果・未達の原因と条件を特定する
主な成果物
- 成功条件
- 失敗条件
- 改善仮説
この段階で起きやすい失敗
- 全体平均で終わる
7. 意思決定
主な目的
- 実用範囲と次の行動を決める
主な成果物
- 最終レポート
- 判断
- 残存リスク
この段階で起きやすい失敗
- 「概ね良好」で終わる
8. 改善・再評価
主な目的
- 設計、データ、運用を更新する
主な成果物
- 改善版
- 再評価計画
この段階で起きやすい失敗
- 同じKPIだけを繰り返す
1. 上位的な内容を見てもらい、評価方針の質を上げるためのフォーマット
1-0. この資料の目的
この段階では完成した評価設計を承認してもらうことを目的にしない。
目的は、
- 業務理解の誤り
- 評価で明らかにするべきこと
- 主要な誤評価リスク
- 追加で必要な知識
について、相手の知識を引き出すことである。
資料の冒頭では「この資料は何か」を説明するより、「何をコメントしてほしいか」を伝える。
1-1. 記入フォーマット
# [案件名]評価設計に向けた論点整理

## 0. 今回ご確認いただきたいこと

最終的な評価設計を作成するため、
現時点の業務理解と評価上の仮説を整理しています。

今回ご確認いただきたいのは以下です。

1.今回の評価で明らかにしたいことが、事業上の期待と合っているか
2.業務理解・守るべき条件に誤りや不足がないか
3.評価結果を誤って解釈する主要なケースに不足がないか
4.詳細設計に向けて追加で把握するべき情報は何か

特に、完成した指標への承認ではなく、
「こういうケースがあるので、そのまま測ると誤る」
という現場・実装上の知識をいただきたいと考えています。

## 1. 今回の評価で明らかにしたいこと

### 到達したい状態

[評価終了時に誰が何を判断できる状態にするか]

### 主な比較

[AI運用]
vs
[現行運用]

必要に応じて、

[AIを使わない簡易ロジック]

との比較も行う。

### 最も重要な業務成果

[この業務で何が改善することを成果と考えるか]

### 明らかにすること

-業務成果は変化したか
-システム能力は必要水準だったか
-成果が出る条件・出ない条件は何か
-AI・人間・運用・データのどこが原因か
-どこまでなら実用化できるか

## 2. 業務として守らなければならないこと

### 絶対条件

-[重大事故]
-[法令]
-[顧客損失]

### 業務制約

-[業務上変更できない条件]

### トレードオフ

[安全性と効率など]

【確認】
この理解で正しいか。
他に守るべき条件があるか。

## 3. 評価を誤らせる主要な要因

現時点では、特に以下を重要だと考えています。

### ① [平易な言葉でリスクを書く]

[説明]

### ② [平易な言葉でリスクを書く]

[説明]

### ③ [平易な言葉でリスクを書く]

[説明]

### その他考えられるもの

-[候補]
-[候補]

【確認】
重要度の認識は正しいか。
該当しないものはあるか。
他に重要なケースがあるか。

## 別依頼:詳細設計に向けて早めに確認したい情報

-AI出力履歴
-人間修正履歴
-実績
-真値
-条件タグ
-モデル/パイプライン
-UI
-テスト対象
-過去実績
1-2. この段階で書きすぎないもの
- 全KPI
- 全テストケース
- 全誤評価リスク
- 詳細な計算式
- 全ログ仕様
- 全判断しきい値
これらは後ろに参考資料として置いてもよい。
前半では、
- 何を知りたいのか
- 何が重要だと考えているのか
- 相手に何を教えてほしいのか
を優先する。
2. PoC型案件の評価要求・評価ラウンド設計フォーマット
2-0. このフォーマットの位置づけ
PoCには、すでに構造が決まっているシステムの性能を測るものだけでなく、実装を通じて、
- 業務構造
- 処理方式
- 品質基準
- 人間とAIの役割
- 実用可能範囲
そのものを発見するPoCがある。
後者では、最初から完成した評価指標を置くことが難しい。
何を品質と呼ぶのか、どこまでをAIに任せられるのか、途中にどのような中間表現や人間判断が必要なのかが、実際に作って評価することで明らかになるためである。
このフォーマットでは、
- PoCで何を発見するか
- どのような失敗を防ぐか
- 評価が何を担うか
- システムのどの層を評価するか
- どの順番で評価するか
を定める。
2-1. PoCの種類
| PoCの種類 | 主に明らかにすること |
|---|---|
| 技術能力検証型 | AIやシステムが要求された処理を実行できるか |
| 構造探索型 | 業務や問題をどの処理単位へ分解するか |
| 品質基準探索型 | 何を良い/悪いと判定するか |
| 運用探索型 | AIと人間をどう組み合わせれば実務が成立するか |
| 実用範囲探索型 | どの条件・対象まで使えるか |
| 経済性検証型 | コストに対して十分な価値があるか |
複数に該当してもよい。
ただし、主要目的は明確にする。
2-2. プロジェクト目標
## 上位目的・ビジョン

[長期的に実現したい状態]

## 今回のPoCの目的

[今回の期間で何を明らかにするか]

## 今回特に重要な学習目標

1.[業務構造として知りたいこと]
2.[システム構造として知りたいこと]
3.[実用範囲として知りたいこと]

## PoC終了後の意思決定

-次の開発へ進む
-設計を変更する
-限定導入する
-別方式を試す
-停止する

## 今回は証明しないこと

-[全面対応]
-[完全自動化]
-[全社展開]
2-3. PoCで解消する不確実性
| ID | 分かっていないこと | 現在の仮説 | なぜ重要か | 何を観測すれば分かるか | 分かった後の判断 |
|---|---|---|---|---|---|
| U1 | |||||
| U2 | |||||
| U3 |
PoCは完成品を作る活動であると同時に、不確実性を減らす活動でもある。
2-4. 起こりうる失敗
| 失敗 | 一見成功しているように見える状態 | 実際の問題 | 評価で防ぐ方法 |
|---|---|---|---|
| 正解との差分を全部直す | 正解例へ近づいている | 業務上不要な品質へ工数を使う | 差分と問題を分ける |
| 暗黙知の回収が遅れる | 実装が進んでいる | 後半で要求・構造が大きく変わる | 初期評価で判断理由を回収 |
| 完全自動化へ偏る | 自動化率が高い | 品質が実用水準へ届かない | 人間確認を含む実用構成も評価 |
| スコープが増え続ける | 対応ケースが増える | 基礎構造が固まらない | コア・境界・探索ケースを分ける |
| 最終出力だけを見る | 不具合は見える | 何を直せばよいか分からない | 処理層別に評価する |
2-5. 評価が担う役割
| 評価の役割 | 明らかにすること |
|---|---|
| 差分と問題の分離 | 正解との差のうち何が業務上問題か |
| 品質構造の明示 | 品質要素・重要度・許容範囲 |
| 暗黙知の回収 | 人間が無意識に使っている判断 |
| 問題発生層の特定 | 入力・解釈・中間表現・生成のどこが原因か |
| Human-in-the-loop設計 | どこで人を入れると実用性が高まるか |
| スコープ境界管理 | 今回直すものと将来課題を分ける |
2-6. 評価対象を処理層へ分解する
入力
 ↓
前処理
 ↓
AIによる解釈
 ↓
中間表現
 ↓
決定的処理・生成
 ↓
最終成果物
 ↓
人間による利用
| 層 | 確認すること | 典型的な問題 |
|---|---|---|
| 入力・前処理 | 必要情報が機械処理可能か | 欠損、表記揺れ |
| 解釈 | AIが意味を正しく取得したか | 誤読、文脈誤認 |
| 中間表現の値 | 正しい値・関係が入ったか | 値誤り、欠落 |
| 中間表現の設計 | 業務構造を十分表現できるか | 変数不足、粒度不整合 |
| 生成 | 中間表現から安定して生成できるか | 変換ロジック不具合 |
| 最終成果物 | 実務上成立しているか | 品質欠陥 |
| 業務利用 | 実際に仕事として成立するか | 手戻り、確認コスト |
2-7. 差分と問題の分類
| 区分 | 内容 | 基本的な扱い |
|---|---|---|
| 致命的問題 | 安全・法令・機能成立へ影響 | 必須修正 |
| 業務上の問題 | 後工程・判断に支障 | 改善対象 |
| 軽微な品質差 | 使えるが望ましくない | 優先度判断 |
| 許容可能な揺らぎ | 意味・機能は同等 | 修正不要 |
| スコープ外 | 今回の対象ではない | 将来課題 |
| 判断未確定 | 現場知識が必要 | ヒアリング対象 |
| ケース | 差分 | 品質要素 | 業務影響 | 重要度 | 原因層 | 今回直すか | 判断理由 |
| --- | --- | --- | --- | --- | --- | --- | --- |
2-8. 完全自動化以外の実用構成
| 確認項目 | 内容 |
|---|---|
| 人へ戻す条件 | どの曖昧さ・例外で確認するか |
| 人が追加する情報 | 何を補えば処理が成立するか |
| 修正対象 | 中間表現を修正できるか |
| 確認時間 | 一件あたりの負荷 |
| 品質効果 | 人間確認でどこまで改善するか |
| 責任 | 最終承認が必要な場所 |
| 実用性 | 完全自動と人間補助型のどちらが合理的か |
2-9. ケースの区分
| ケース区分 | 意味 | 合否への扱い |
|---|---|---|
| コアケース | 今回必ず成立させる | 合否対象 |
| バリエーション | コア構造の組み合わせ | 原則合否対象 |
| 境界ケース | 成立/不成立の境を見る | 実用範囲特定 |
| スコープ外探索 | 将来の構造を知るために流す | 不合格として扱わない |
| 対象外 | 今回検証しない | 評価対象外 |
2-10. 評価ラウンド
| ラウンド | 主な問い | 評価の性質 |
|---|---|---|
| 1回転目 | 何ができ、何が問題で、何を品質と呼ぶか | 探索・品質モデル発見 |
| 2回転目 | 問題はどこにあり、処理構造は妥当か | 原因分析・設計評価 |
| 3回転目 | どこまで使え、どこから破綻するか | 実用範囲・意思決定 |
1回転目:エンドツーエンド初期評価
目的は最終合否ではなく、
- できていること
- できていないこと
- 品質要素
- 重要度
- 許容差
- 暗黙知
を発見すること。
代表ケース数件〜十数件でよい。
2回転目:中間処理・構造評価
1回転目で見つかった問題について、
- 入力
- AI解釈
- 中間表現
- 中間表現の設計
- 生成
のどこに原因があるかを見る。
この段階では、システム構造そのものを評価する。
3回転目:総合評価
最終的に、
- 成立するケース
- 破綻するケース
- 人間確認が必要なケース
- 実用範囲
- 非対応領域
- 今後の拡張
を明らかにする。
スコープ外ケースが処理できないこと自体は失敗ではない。
なぜ処理できず、どの程度の変更が必要かを説明できることが重要になる。
2-11. 評価ラウンド計画フォーマット
| ラウンド | 実施時期 | 実装状態 | 評価で答える問い | 対象ケース | 評価方法 | 主な成果物 | 次の判断 |
|---|---|---|---|---|---|---|---|
| R1 | |||||||
| R2 | |||||||
| R3 |
参考例:構造探索型PoCにおける評価要求・3ラウンド設計
分電盤図面生成・簡易DSL設計PoC
本事例は、完成したシステムの性能だけを測るPoCではない。
図面作成業務の処理構造、簡易DSLの設計指針、限定ユースケースでの実現可能性を発見する構造探索型・品質基準探索型・実用範囲探索型PoCとして位置づける。
そのため評価は、最終図面の正しさを確認するだけでなく、
- 品質基準の発見
- 暗黙知の回収
- 問題発生層の特定
- DSL構造の妥当性確認
- 実用可能範囲の特定
という役割を持つ。
要求
プロジェクトの目標
概要
分電盤図面作成業務において、諸元表等の入力情報から図面生成に至る処理を機械的に担うためのシステム構造を明らかにし、その実現可能性を検証するPoC。
単なる業務自動化ではなく、業務構造および処理方式を特定することを重要な目的とする。
重要な目標
- 図面生成業務の構造の明確化
- 諸元表から図面に至るまでの判断・補完・処理を、機械処理可能な単位で整理する
- 簡易DSLの設計指針の特定
- 業務効率と安定性を両立するために必要な中間表現の構造・粒度・パラメータ設計を明らかにする
- 限定ユースケースにおける実現可能性の把握
- 代表ケースに対して、どの範囲まで接続関係・配置・図面生成が成立するかを具体物ベースで確認する
上位的な目的・ビジョン
ドメスティックな業務記述と、一般的なプログラミング言語の中間にあるような開発言語・中間表現を創造する。
その構造を、AIを用いることで従来より高速に発見・実装し、実用可能な状態まで育てる。
今回のPoCでは、その最終構想すべてを証明するのではなく、図面生成という具体的な業務を通じて、その基礎となる構造が成立するかを確認する。
起こりうる失敗
1. 「正解図面との差分=不正解」と扱いすぎる
正解図面との差分をすべて問題として扱い、自動処理であれば合わせる必要のない品質まで追いかけてしまう。
例えば、
- 色
- 配置
- 表現
- ラベル位置
などの差があっても、業務利用上問題がない場合がある。
一方で、小さな差でも接続関係などは重大な問題になる。
評価では、差分の有無と業務上の問題を分ける。
2. 暗黙知の回収が遅延する
実際には作業上存在している暗黙知や暗黙的要件の回収が遅れ、実装工期が少ない段階で要求やDSL構造が大きく変動する可能性がある。
評価初期から、
- なぜこの図面は違うのか
- なぜこの表現でなければならないのか
- このケースでは人間は何を見て判断しているのか
を回収する。
3. 完全自動化偏重によって実用性へ届かない
諸元表だけから完全自動で図面生成することへ固執すると、曖昧な情報をAIが推測し続ける構造になる可能性がある。
一方、
- 人間へ一問確認する
- DSLを人が一部補正する
- 特定ケースだけ人へ戻す
ことで品質が大幅に安定する可能性がある。
完全自動化率ではなく、実用的な人間とAIの役割分担を見る。
4. スコープ外ユースケースが事後的に増え続ける
未定義・未検証ケースを発見するたびに実装対象へ追加すると、DSLの基礎構造が固定できない。
ケースを、
- コア
- バリエーション
- 境界
- スコープ外探索
に分ける。
スコープ外ケースは、今回すべて対応するのではなく、現在のDSLでどこまで表現できるかを確認するために使用する。
5. 最終図面だけを見て問題発生層が分からなくなる
図面が間違っていることだけ分かっても、
- 諸元表の読み取りが間違った
- 解釈が間違った
- DSLへ正しく変換できなかった
- DSL自体に必要な概念がない
- DSLから図面への生成処理が間違った
のどれなのか分からなければ改善できない。
評価では処理層を分ける。
失敗を防ぐための品質評価の役割
1. 「差分」と「問題」を分離する
正解図面との差分を抽出することと、その差分が業務上問題かどうかを判定することを分ける。
2. 業務品質の評価軸を明示する
評価を通じて、
- 図面品質を構成する要素
- 接続
- 配置
- 表現
- ラベル
- 色
- 各要素の重要度
- 許容される揺らぎ
を詳細化する。
3. 暗黙知を顕在化・回収する
「このケースは例外」
「ここはこう判断している」
といった指摘を、単なる修正コメントで終わらせず、判断ルールとして記録する。
4. 問題の発生層を特定する
問題原因を、
- 諸元表
- AI解釈
- DSL変換
- DSL構造
- 図面生成
へ切り分ける。
5. 完全自動化と人間補助型の境界を特定する
どの条件なら完全自動で成立し、どの条件では追加情報や人間確認が必要になるかを確認する。
基礎的な品質評価対象
1. 図面ファイルの質
DSLをもとに生成された図面が業務上成立しているか。
2. 解釈結果のDSL化の質
DSL各パラメータが、諸元表・業務上の意味を正しく表現しているか。
3. DSLの設計の質
独自構造化言語として、
- 変数の階層
- 分解粒度
- 詳細度
- 組み合わせ可能性
- 例外表現
- 拡張性
が業務実態のカバーに適しているか。
4. 諸元表へのAI解釈の質
- 諸元表に対する前処理
- 項目抽出
- 意味解釈
- 接続関係の推定
- 不明値の扱い
が妥当か。
評価プロセス
1回転目. エンドツーエンドでの初期評価
想定実施時期
初期プロトタイプ成立直後。
想定実装状態
- 諸元表 → DSL → 図面生成の一連の処理が動作
- 接続関係は部分的に成立
- 配置・表現は粗くてもよい
- 正解図面との比較が可能
評価の目的
プロトタイプを用いたエンドツーエンド処理を対象に、現時点のアウトプット品質を広く評価する。
明らかにするのは、
- 何ができているか
- 何ができていないか
- 図面品質を構成する評価項目
- 各項目の重要度
- 許容可能な差分
- 修正するべき差分
- 現時点で不足している暗黙知
である。
特に、
「差分があること」
と
「それが業務上問題であること」
を分けてエンドクライアントと認識を揃える。
評価対象の数・幅
- 代表ケース数件〜十数件
- 構造が異なるケース
- 正常系中心
- 軽度の差異を含むケース
評価形式
- エンドツーエンド出力評価
- 正解図面との差分抽出
- 評価項目への分解
- 各項目の一致/不一致
- 業務影響
- 重要/許容可能/対象外の分類
粒度は、
「何が違うか」
だけでなく、
「今回それを直す必要があるか」
まで判断できる水準とする。
主な成果物
- 品質評価項目の初版
- 差分分類
- 重要度
- 許容差
- 暗黙知一覧
- 次回の原因分析対象ケース
2回転目. 中間処理・DSL設計評価
想定実施時期
第1評価後の中盤フェーズ。
想定実装状態
- DSL構造が定義されている
- 諸元表 → DSL変換が安定し始めている
- DSL → 図面生成が概ね機械的に実行可能
評価の目的
エンドツーエンド評価で明らかになった差分・不具合をもとに、その原因を特定する。
さらにDSL設計の妥当性を見る。
特に、
- 接続関係を表現できるか
- DSLパラメータが必要十分か
- DSL階層が妥当か
- 図面生成へ安定して接続できるか
- 不明・例外を表現できるか
- 人間が確認・補正可能か
を確認する。
評価対象
- 第1評価ケース
- 問題が発生したケース
- 接続・構造が複雑なケース
- DSLの境界が見えやすいケース
評価形式
- 諸元表解釈結果
- DSL各パラメータの正誤
- 接続関係
- DSL構造と図面差分の対応
- 問題発生層
- DSL変更前後の回帰確認
主な成果物
- 問題発生層マップ
- DSL変更方針
- パラメータ定義
- 例外表現
- 人間確認箇所
- 回帰テストケース
3回転目. 総合評価
想定実施時期
最終フェーズ。
想定実装状態
- 一通りの処理パイプラインが完成
- DSL設計・変換が一定の安定性を持つ
- 複数ケースで評価結果が蓄積済み
評価の目的
成立する範囲、破綻する条件、未対応パターンを明確にし、実運用への適用範囲と次の開発方針を整理する。
本PoCで構築した処理ラインへ、
- 今回対象としたユースケース
- 境界ユースケース
- スコープ外探索ユースケース
を流す。
評価対象
- PoC対象ケース一式
- 回帰ケース
- 未検証ユースケース
- 難易度の異なる追加ケース
評価形式
- 全ケースの通過可否
- ケース別の成立/不成立
- 不成立理由の分類
- AI解釈/DSL/生成の原因層
- Human-in-the-loopが必要な範囲
- 未対応パターン
- 拡張に必要な構造
最終的に明らかにすること
- どのケースなら実用化できるか
- どこでは人間確認が必要か
- どこではまだ使用できないか
- 現在のDSLでどこまで表現できるか
- どこからDSLの構造変更が必要か
- 次の開発で何を優先するか
スコープ外ケースが処理できないこと自体は、PoC失敗とはしない。
なぜ処理できなかったのか、それを解消するには何が必要なのかを説明できる状態を成果とする。
最終レポートで回答する問い
- 諸元表から図面生成までの業務構造を、どこまで機械処理可能な単位へ分解できたか
- 簡易DSLは、今回対象とした図面構造を十分に表現できたか
- 図面品質上、必ず一致すべき要素と許容可能な揺らぎは何か
- 問題が発生する場合、諸元表解釈・DSL変換・DSL構造・図面生成のどこが原因だったか
- 完全自動化できる範囲はどこか
- 人間確認を入れることで実用化できる範囲はどこか
- 今回の構造で対応できないケースは何か
- 既存DSLの拡張で対応できるものと、構造変更が必要なものは何か
- 次の開発フェーズへ進む合理性は確認できたか
- 次フェーズで優先して解消する不確実性は何か
3. 実際に評価を行うための必要十分な評価設計書フォーマット
3-1. 評価の目的
この評価によって何を意思決定できるようにするか
- 継続
- 改善して再評価
- 対象範囲を限定して実用化
- 展開
- 停止
評価終了時に明らかになっているべきこと
- 何ができるか
- 何ができないか
- どの条件なら再現するか
- 何が改善されれば次へ進めるか
3-2. 崩せない前提・制約
| 条件 | 内容 |
|---|---|
| 致命条件 | 一度でも発生すると実用化できない事象 |
| 法務・安全 | 必ず守る必要がある条件 |
| 業務制約 | 現場上変更できない条件 |
| 評価対象外 | 今回は判断しない範囲 |
Gateと、改善量を見るKPIを混ぜない。
3-3. 評価対象となる業務とシステム
現状業務
[業務フロー]
AI介入後
[AI・人間・既存システムの役割]
処理層別評価マップ
| 処理層 | 入力 | 出力 | 品質上の問い | 典型的失敗 | 評価方法 | 改善主体 |
|---|---|---|---|---|---|---|
| 入力 | ||||||
| AI解釈 | ||||||
| 中間表現 | ||||||
| 生成 | ||||||
| 最終出力 | ||||||
| 業務利用 |
3-4. 何を明らかにするか
システム能力
- 予測
- 分類
- 抽出
- 判断
- 生成
- 制約遵守
- 致命的失敗
業務成果
- 工数
- 処理量
- コスト
- 品質
- 売上
- 安全
- 顧客体験
実用可能範囲
- 業務種
- ケース
- 顧客属性
- 担当者
- 難易度
- データ状態
- 拠点
3-5. 誤評価リスク
KPIより先に、
「どうすると誤った結論になるか」
を列挙する。
| 誤評価ケース | 起きる誤解 | 対策 |
|---|---|---|
| AIは正しいが人が使わない | AIを過小評価 | 遵守別に分割 |
| AIを人が修正 | AIを過大評価 | 修正前後を保存 |
| 簡単なケースへ偏る | 全体性能を過大評価 | 条件タグ |
| 真値が不正確 | AI精度を誤る | 真値出所記録 |
| PoCだけ特別運用 | 本番再現性を過大評価 | 通常との差を記録 |
3-6. 評価指標
A. 合否・成果指標
| 指標 | 現状 | 目標 | 判断基準 | 集計単位 |
|---|---|---|---|---|
B. 解釈・フィルタリング指標
| 指標 | 何を区別するか | 評価には直接使うか |
|---|---|---|
| AI指示との一致率 | AI性能と運用不遵守 | 原則使わない |
| 人による修正率 | AI単体寄与 | 原則使わない |
| 担当者属性 | 人による差 | 層別用 |
| ケース条件 | 適用範囲 | 層別用 |
C. 指標メタデータ
| 指標 | 品質層 | 原因層 | 評価ラウンド | 基準Ver |
|---|---|---|---|---|
3-7. 比較対象
| 比較対象 | 内容 |
|---|---|
| 現行業務 | 人間+既存システム |
| 単純ロジック | 過去値、ルールベース |
| AI業務 | AI+人間+既存システム |
「AIが何点か」ではなく、
「AIを使うことで何が変わったか」
を見る。
3-8. 評価ケース
単票ケース
| ケース | 条件 | 期待結果 | 正解の出所 | スコープ区分 |
|---|---|---|---|---|
束ケース
| ケース | 条件 | 期待する業務成果 | 評価単位 |
|---|---|---|---|
ケースメタデータ
| ケース | 構造差 | 期待する学習 | 原因追跡可能か | 回帰対象か |
|---|---|---|---|---|
3-9. Accuracy / Recall / Precision設計
分類・検出系では最低限、
- Accuracy
- Recall
- Precision
- False Positive
- False Negative
のうち何を優先するかを定める。
特にRecall型では、
| 項目 | 確認内容 |
|---|---|
| 見逃し件数 | 許容可能か |
| ピックアップ件数 | 人間確認可能か |
| 人間確認工数 | 経済性が成立するか |
| 境界ケース | どこまでAIへ任せられるか |
| 多段処理 | 一次・二次判定が必要か |
を併記する。
3-10. 計測設計
| 見たいこと | 必要データ | 取得方法 | 取得タイミング | 復元可能性 |
|---|---|---|---|---|
| AI出力 | AIログ | 自動 | 実行時 | 後から不可 |
| 人の修正 | 修正履歴 | UIログ | 実行時 | 後から不可 |
| 最終結果 | 業務実績 | 基幹 | 実行後 | 可 |
| 判断理由 | 人の認識 | 観察・ヒアリング | 実行直後 | 後から困難 |
3-11. 評価ラウンド計画
| ラウンド | 目的 | 評価基準の状態 | 実装変更 | 対象 | 終了条件 |
|---|---|---|---|---|---|
| R1 | 品質軸発見 | 仮 | 大 | 代表ケース | 品質軸が定まる |
| R2 | 原因分析 | 更新中 | 中 | 問題ケース | 構造が安定 |
| R3 | 実用範囲 | 原則固定 | 小 | 全対象 | 判断材料が揃う |
3-12. 判断ロジック
| 結果 | 判断 |
|---|---|
| 成果あり・再現性あり | 実用化/拡大 |
| 一部条件のみ | 限定導入 |
| システム性能あり・業務成果なし | 運用/UI改善 |
| システム性能不足 | AI改善 |
| 簡易方法と差なし | AIである必要性再検討 |
| 判断材料不足 | 追加計測 |
| 致命条件抵触 | 停止/適用除外 |
3-13. 最終レポート
最終レポートはKPI一覧ではなく、以下への回答として作る。
- AIを使う価値は確認できたか
- システム能力は必要水準だったか
- どの範囲なら実用化できるか
- 成果はAIによって生じたと言えるか
- 成果・失敗の原因は何か
- 人間による補完はどこまで必要か
- 再現性を妨げているものは何か
- 残っているリスク・測れない範囲は何か
- 次にどの意思決定を行うべきか
構造探索型PoCでは追加で、
- どの処理構造が成立したか
- どの中間表現・データ構造が有効だったか
- どの暗黙知を回収できたか
- 既存構造の拡張で対応可能な範囲はどこか
- 根本的な構造変更が必要になる条件は何か
を回答する。
4.評価設計完了チェックリスト
目的・意思決定
- 評価終了後の意思決定が明確
- 判断者が明確
- 「何を判断できれば成功か」が明確
- 全面展開以外の判断も存在する
業務
- 業務価値を理解している
- 崩せない制約を把握している
- 現在の人間判断を理解している
- 例外運用を理解している
- 数字に出ない価値も確認している
AI・システム
- 処理パイプラインを理解している
- AI、人間、既存システムの境界が明確
- 中間表現があれば値と構造を分けている
- モデル・プロンプト等のバージョンを残せる
誤評価
- 運用不遵守
- 人間修正
- ケース偏り
- 母数不足
- 交絡
- 真値
- 観測バイアス
- テスト期間特有の運用
を検討している。
指標
- 成果指標と解釈指標を分けている
- システム能力と業務成果を分けている
- Gateと改善指標を分けている
- 正しい集計単位を選んでいる
- Accuracy / Recall / Precisionのどれを重視するか明確
比較
- 現行業務との比較がある
- 必要なら単純ロジックとの比較がある
- 比較条件が揃っている
- AI導入前後だけで因果を断定しない
データ
- 後から取得不能なデータを特定している
- AI出力履歴が残る
- 人間修正履歴が残る
- 真値の出所が分かる
- 条件タグがある
ケース
- コアケースが明確
- 境界ケースがある
- スコープ外探索ケースを区別している
- 母集団とケース構成の関係を説明できる
- 過去の失敗ケースを回帰ケースとして残す
PoC進行
- PoCの種類が明確
- 解消する不確実性が明確
- 各評価ラウンドの問いが異なる
- 品質基準を育てる時期と固定する時期を分けている
- 各ラウンドに終了条件がある
最終判断
- 成果が出た場合の判断がある
- 一部だけ成果が出た場合の判断がある
- システムは良いが運用が悪い場合の判断がある
- AIが悪い場合の判断がある
- AIでなくてもよい場合の判断がある
- 判断材料不足の場合の判断がある
評価設計と進行で起きる主な誤解と失敗
目的に関する誤解
AIの精度が高ければ実用化できる
- 実態
- 精度はシステム能力の一部であり、業務成果、運用、責任、コストとは別である
- 起きる失敗
- 高精度だが使われない
- 業務が変わらない
KPIを達成することが評価のゴールである
- 実態
- KPIは意思決定に必要な材料であり、ゴールは次の判断ができる状態である
- 起きる失敗
- 数字は出たが、継続か停止か決まらない
PoC開始時の成功条件を最後まで守れば公平である
- 実態
- PoCでは業務理解が進み、成功条件そのものが更新されることがある
- 起きる失敗
- 新しく分かった重要な事実が評価へ反映されない
全社・全件で使えなければ失敗である
- 実態
- 特定条件、特定担当者、低リスク領域だけでも価値が成立することがある
- 起きる失敗
- 実用可能な部分まで捨てる
評価は開発後の検査工程である
- 実態
- 生成AIでは評価が設計・実装・改善の各工程に入り込む
- 起きる失敗
- 意味のずれを終盤まで放置する
指標に関する誤解
「精度」という一つの数字で性能を表せる
- 実態
- Accuracy、Precision、Recall、誤差方向、致命度、安定性は異なる
- 起きる失敗
- 危険な見逃しと軽微な誤差を平均する
同じ10%の誤差は同じ失敗である
- 実態
- 過大予測と過小予測では、業務損失が非対称なことがある
- 起きる失敗
- 平均誤差は良いが、重大事故につながる
AI利用率が高ければ役に立っている
- 実態
- 利用率は性能ではなく、成果を解釈するための条件になることがある
- 起きる失敗
- 使われたが間違っていたAIを高評価する
全体平均が改善していれば成功である
- 実態
- 一部の人、条件、拠点だけが改善している可能性がある
- 起きる失敗
- 再現条件と失敗条件を見失う
測りやすい数字ほど重要である
- 実態
- 不安、二重確認、例外処理、関係性など、取得しにくい要因が実用性を左右する
- 起きる失敗
- 重要ではない数字だけが充実する
1件ごとの正解率を見れば業務全体も分かる
- 実態
- 個票の性能と、1日・1ルート・1担当者単位の成果は異なる
- 起きる失敗
- 個別では正しいが、束ねると非効率になる
AIと人間の関係に関する誤解
AIの出力がそのまま業務成果になる
- 実態
- 人間の確認、修正、無視、既存システムとの照合が介在する
- 起きる失敗
- AI単体の寄与が分からない
AIに従わなかったケースはノイズなので除外すればよい
- 実態
- 従わなかった理由が、AI性能、UI、不信、現場知識のどれかで意味が変わる
- 起きる失敗
- モデル改善と運用改善を取り違える
人による修正が多いほどAIは失敗である
- 実態
- 修正が正しい場合と、AIの方が正しい場合がある
- 起きる失敗
- 熟練者の補正でAIを過大評価、または過小評価する
現場を同じ操作へ統一すれば評価しやすい
- 実態
- 人間の行動は不統一でも、業務状態を統一できれば成立する場合がある
- 起きる失敗
- 新しい入力負担が増え、現場で使われない
PoCで使われたなら本番でも使われる
- 実態
- テスト期間は確認が丁寧で、支援も多く、協力的な人に偏りやすい
- 起きる失敗
- 本番再現性を過大評価する
進行と資料に関する誤解
詳細な完成版を早く出すほど良い
- 実態
- 初期段階では、相手の知識を引き出すための上位論点の合意が先に必要である
- 起きる失敗
- 正しそうな仮説が相手の思考を止める
リスクは網羅的に並べればよい
- 実態
- 相手が必要なのは、設計者が何を主要リスクと見ているかである
- 起きる失敗
- 項目が多すぎて、重要度の議論が起きない
不足データはテスト後に集めればよい
- 実態
- AI出力、変更前後、判断理由、実行時の状態は後から復元できない
- 起きる失敗
- 評価したいのに計測できない
第三者評価は別会社が測れば成立する
- 実態
- 第三者性は、実装側の前提から独立して成功条件を問い直せることにある
- 起きる失敗
- 発注者や実装者のKPIを追認するだけになる
評価方針のレビューと情報提供依頼は同じ資料でよい
- 実態
- 考え方へのレビューと、詳細設計に必要なデータ依頼は別の行為である
- 起きる失敗
- 読み手が何に回答すべきか分からない
必要な知識や視点の全体像
評価設計に必要な知識の全体像
生成AI・LLMの評価設計には、モデルの精度指標だけでなく、業務、データ、人間、組織、意思決定に関する知識が必要になる。
なぜなら、実務で評価する対象はAI単体ではないからである。AIが出力し、人間が確認・修正し、既存システムと組み合わされ、その結果として業務上の成果や損失が生まれる。この一連の構造を理解せずに数字だけを測ると、計測自体は正しくても、AIの実用性について誤った結論を出すことがある。
評価設計に必要な知識は、大きく以下の7カテゴリーに分けられる。
- 生成AI評価の根本的な性質
- 実用性を評価するための基本構造
- 指標・集計・因果を誤読しないための知識
- AI処理の内側と生成物を評価するための知識
- 評価基準と評価ケースを育てるための知識
- 人間・第三者・組織が評価に関わる意味
- 評価プロジェクトを正しく進めるための知識
1. 生成AI評価の根本的な性質
1-1. 生成AIの評価は、従来のシステムQAと性質が異なる
従来のシステムQAでは、あらかじめ定められた入力に対して、想定された処理や出力が行われるかを確認することが中心になる。ボタンを押したときに正しい画面へ遷移するか、計算結果が仕様通りか、異常な入力でエラー処理が行われるか、といった確認である。
生成AIでも、APIが動くか、処理が停止しないか、権限やセキュリティに問題がないかといった通常のQAは必要になる。しかし、それだけでは生成AIの品質を判断できない。
生成AIは、処理内容が誤っていても、文法的には自然で、もっともらしい出力を返すことがある。検索するべき情報を間違えていても自然な回答を生成できる。顧客の意図を誤解していても、丁寧な文章を返すことができる。必要な判断を避けているのに、会話としては成立していることもある。
そのため、生成AIでは次のような状態が頻繁に起きる。
- システムは正常終了している
- APIも成功している
- 出力も存在している
- 文章も自然である
- しかし、業務上の目的は達成していない
例えば、「挨拶に対して、相手が次の話をしやすくなる話題を返す」という目的に対し、「こんにちは」とだけ返したとする。システムとしては動いているが、期待された能力は発揮していない。
生成AIの評価では、動作の有無だけでなく、意味、文脈、程度、妥当性、責任を持って使えるかまで確認する必要がある。
また、同じ入力に対して出力が一定しない場合もあるため、「一度正しく答えた」だけでは安定した能力があるとは言い切れない。代表ケースだけでなく、類似ケース、境界ケース、言い回しを変えたケースでも同じ判断ができるかを見る必要がある。
1-2. 評価とは、正解判定ではなくシステムを理解する仕事である
評価は、AIの出力へ正解・不正解を付ける作業だと思われやすい。しかし、実用化に必要な評価は、点数を付けるところで終わらない。
評価によって本当に明らかにしたいのは、次のような事実である。
- AIは何ができているのか
- 何ができていないのか
- どの条件で失敗するのか
- なぜその失敗が起きたのか
- どこを変えれば改善するのか
- どの範囲なら現在の能力でも使えるのか
スコアが低いという事実だけでは、次の改善行動は決まらない。原因がモデルにあるのか、プロンプトにあるのか、RAGの検索にあるのか、入力データにあるのか、業務ルールにあるのかによって、必要な改善は異なる。
例えば、社内FAQへの回答が間違っていた場合でも、原因には複数の可能性がある。
- 必要な文書がデータベースに存在しない
- 文書はあるが検索で取得できていない
- 正しい文書を取得したが内容を誤読した
- 内容は理解したが、組織の回答ルールを知らない
- 回答自体は正しいが、顧客へ伝える表現として不適切だった
- AIは正しかったが、人間が誤って修正した
最終出力だけを見ると、どれも「回答が悪かった」という一つの症状に見える。評価では、この症状がどの処理層から生まれたのかを追跡する。
評価が水漏れ箇所を探す仕事に例えられるのはこのためである。床が濡れていることを確認するだけでは修理できない。配管、接続部、屋根、排水のどこから水が来ているかを特定して初めて、直すべき場所が分かる。
したがって、良い評価設計とは、点数を細かくすることではない。悪い結果が出たときに、その原因を切り分けられる構造を持つことである。
1-3. 評価は、AIを実用可能な能力へ育てるプロセスでもある
生成AIの評価は、完成品に対する最終検査だけではない。設計・実装の途中で繰り返し行われ、AIシステムが持つ能力そのものを形づくる。
初期の設計段階で、あらゆる入力、例外、顧客状態、業務条件を想定し、完璧な指示を書くことは難しい。人間の業務には、文書化されていない判断や、状況に応じた例外処理が多く含まれているためである。
一方、実際の出力を30件並べて見ると、現場の人は次のような判断を行える。
- 通常の問い合わせには対応できている
- 金銭に関する回答は危険である
- 感情的なクレームに対する配慮が足りない
- この種類の質問では検索対象を間違えている
- この条件なら回答せず、人へ渡すべきである
出力を見ることで、頭の中では言語化できていなかった業務ルールが具体化される。その結果、プロンプトを追加する、処理を分ける、検索方法を変更する、危険なケースを人へ渡すといった設計変更が生まれる。
ここでいう「AIを育てる」は、必ずしもモデル自体を追加学習することではない。実務で使われるAIシステムの能力は、次の要素の組み合わせによって成立する。
- モデル
- プロンプト
- 入力データ
- RAG
- ルール処理
- 中間表現
- UI
- 人間確認
- フォールバック
- 例外処理
評価と改善を繰り返し、これらの組み合わせを調整することで、最終的に実務で働ける能力が成立する。
このプロセスは、製造業の試作工程に近い。完成品を最後に検査するだけでなく、素材を試し、部品を試し、条件を変えて耐久性を確認し、必要な性能になるまで設計を更新する。生成AI評価も、実用に耐える仕組みを作り上げるための試験工程として機能する。
2. 実用性を評価するための基本構造
2-1. システム能力と業務成果を分けて評価する
生成AIの実用性を判断するには、「AIが正しく処理できたか」と「AIを入れたことで業務が良くなったか」を分ける必要がある。
| 評価対象 | 主語 | 確認すること | 例 |
|---|---|---|---|
| システム能力 | AI・システム | 単体機能として何ができたか | 正解率、検索精度、誤差、制約違反、処理時間 |
| 業務成果 | AIを含む業務全体 | 現場や事業に何が起きたか | 工数、処理量、売上、品質、事故、顧客体験 |
| 解釈条件 | 人・運用・データ | なぜその結果になったか | AI指示との一致度、修正率、担当者属性 |
| 実用範囲 | 条件・対象 | どこまでなら再現するか | 業務種、顧客属性、難易度、拠点、データ品質 |
システム能力が高くても、業務成果が出ないことがある。例えば、AIが高品質な文章を生成できても、顧客がその文章を読んでいなければ成果にはつながらない。作業時間を短縮しても、空いた時間を価値ある仕事へ使えなければ売上は増えない。
反対に、業務成果が改善していても、AIが優秀だったとは限らない。テスト期間中に管理者の支援が増えた、優秀な担当者だけが参加した、業務ルールを同時に変更した、といった別要因が成果を生んでいる可能性がある。
そのため、二つは単純な上下関係ではない。システム能力は業務成果の一部を説明するが、それだけで業務成果は決まらない。業務成果は実用価値を示すが、それだけでは改善対象を特定できない。
評価設計では、両方を別々に取得し、最後に因果関係として接続する必要がある。
例えば、次のように説明できる状態が望ましい。
AIの検索と回答能力は必要水準に達していた。AI回答をほぼそのまま利用したケースでは対応時間が短縮された。一方、特定カテゴリでは検索失敗が多く、人間による再確認が増えたため、全体の業務成果は限定的だった。
この説明には、システム能力、業務成果、人間の利用状況がすべて含まれている。
2-2. 制約・Gateと改善指標を分ける
すべての評価項目を、平均点や改善率として扱うことはできない。
業務には、平均的に良ければ許容できる指標と、一度でも発生すると実用化できない事象が存在する。
例えば、次のようなものはGateとして扱われることがある。
- 安全事故
- 法令違反
- 個人情報の漏えい
- 重大な金銭損失
- 供給停止
- 契約上禁止された判断
- 顧客へ重大な不利益を与える誤案内
これらを通常の精度へ混ぜると、重大性が消える。
1000件中999件が正しく、1件で重大事故が起きたシステムを「99.9%の精度」と評価しても、実務では使えない場合がある。平均精度が高いことと、重大リスクを制御できていることは別である。
評価設計では、少なくとも次の三つを分ける。
| 区分 | 意味 | 例 |
|---|---|---|
| Gate・絶対条件 | 抵触した場合、その条件下では使えない | 法令違反、重大事故 |
| 成果指標 | どれだけ改善したかを見る | 工数、コスト、処理量 |
| 診断指標 | 成果・未達の理由を説明する | 誤差、検索失敗、修正率 |
また、Gateに抵触したからといって、システム全体が必ず全面停止になるとは限らない。特定の顧客、業務、データ条件でのみ発生するなら、その条件を実用範囲から外す判断もありうる。
重要なのは、Gateを平均値へ埋め込まず、「どの条件で抵触したか」を特定することである。
2-3. Human-in-the-loopは、自動化の失敗とは限らない
AIの処理途中に人間確認が残ると、「完全自動化できなかった」と評価されることがある。しかし、実務では人間を含む構造の方が、品質、コスト、責任のバランスに優れる場合がある。
例えば、全ケースの90%はAIが自動処理できるが、残り10%は情報が曖昧だとする。この10%についてAIに推測させ続けるより、人間へ一問確認し、その結果をもとに処理する方が合理的なことがある。
Human-in-the-loopには複数の形がある。
- AIが作った最終出力を人間が承認する
- AIが不確実なケースだけ人へ渡す
- 人間が不足情報を入力する
- 人間が中間表現だけを修正する
- AIが複数案を出し、人間が選択する
- 重大ケースだけ専門家が判断する
完全自動化率が高いことと、業務全体として優れていることは同じではない。人間確認を減らしすぎることで重大なミスが増える場合もあれば、人間確認を広く残しすぎることで業務効率が上がらない場合もある。
評価では、自動化率だけでなく、次を確認する必要がある。
- 人間へ戻す件数
- 一件あたりの確認時間
- 人間確認による品質改善
- 確認者に必要な専門性
- 最終責任
- AIだけの場合とのコスト差
- 人間が確認できる件数の上限
Human-in-the-loopは、AIが弱いから仕方なく置くものではない。業務上必要な品質と責任を成立させるための設計要素である。
3. 指標・集計・因果を誤読しないための知識
3-1. システムの処理単位ではなく、業務上価値が生まれる集計単位を選ぶ
AIは通常、一件の問い合わせ、一つの文書、一人の顧客、一つの画像などを単位として処理する。しかし、業務成果が同じ単位で発生するとは限らない。
例えば、配送計画では顧客一件ごとの需要予測が評価できても、実際の業務成果は一日分のルート、車両の積載、担当者の稼働時間によって決まる。
個々の予測が正しくても、ルート全体で遠回りになっていれば業務成果は悪い。反対に、個々の予測には誤差があっても、ルート全体で吸収されていれば業務上の損失は小さいことがある。
評価では、少なくとも次の二つを区別する。
- AIが処理している単位
- 業務として成果や損失が発生する単位
主な集計単位には次がある。
- 一入力・一回答
- 一顧客
- 一案件
- 一担当者
- 一日
- 一ルート
- 一拠点
- 一チーム
- 一カ月
- 一業務サイクル
一つの評価に複数の単位が必要になることも多い。個票単位はAI能力の診断に使い、担当者・一日・拠点単位は業務成果の判断に使うといった分担である。
「何件正しかったか」だけでなく、「現実ではどのまとまりで価値や損失が生まれるか」を基準に集計単位を選ぶ必要がある。
3-2. 全体平均と条件別評価を両方持つ
全体平均は、プロジェクト全体として成果が出ているかを見るために必要である。経営判断では、最終的に全体のコスト、処理量、売上、品質がどのように変わったかが重要になる。
一方、全体平均だけでは、どこで成果が出たか、どこで失敗したかが分からない。
全体で10%改善していても、実態には複数の可能性がある。
- ベテランは改善したが、新人は悪化した
- 特定の拠点だけ改善した
- 簡単なケースだけ大きく改善した
- AIに従わなかった人の数値が改善した
- 一部の大口顧客によって平均が押し上げられた
- 重大ケースだけ失敗している
この違いによって、次の判断は変わる。全面導入できるのか、限定導入すべきか、教育が必要なのか、モデルを改善すべきかが異なるためである。
そのため、評価は次の二層で持つ。
- マクロ評価:全体として成果が出たか
- ミクロ評価:どの条件で成果・失敗が起きたか
条件別評価の候補には、次がある。
- 担当者・習熟度
- 顧客属性
- 業務カテゴリ
- 難易度
- 拠点
- 入力データ品質
- AIへの遵守度
- モデル・プロンプトのバージョン
- 時間帯・季節
- リスク区分
ただし、結果が出た後で都合のよい条件だけを探すと、偶然の差を意味ある差として扱う危険がある。重要だと考える条件は事前に定義し、探索的に見つけた条件は「追加仮説」として次の評価で確認する必要がある。
3-3. AI導入後の変化と、AIによって生じた変化を区別する
AI導入後に業務成果が改善したとしても、それだけではAIの効果とは言い切れない。
同じ期間に、次のような変化が起きている可能性がある。
- 人員が入れ替わった
- ベテランが追加で支援した
- 業務ルールが変更された
- 顧客数や需要が変化した
- 季節や天候が異なった
- PoCであるため通常より丁寧に対応した
- 対象ケースが簡単だった
このような、AI以外の要因が結果へ影響することを交絡と呼ぶ。
評価では、「AI導入期間の数字が良い」という相関だけでなく、どこまでAIへ成果を帰属できるかを確認する。
理想的な比較方法は案件によって異なるが、次のような方法がある。
- AI運用と現行運用を同期間・同条件で比較する
- AIの提案を実行した群と、実行しなかった群を分ける
- AIを使わない簡易ロジックと比較する
- 対象者やケース条件を揃える
- 導入前後で人員や需要条件の差を記録する
- 実運用を変えず、AI案だけ並行生成する
- バージョン変更前後を分けて集計する
完全な因果証明ができない案件もある。その場合でも、どの要因を分離でき、どの要因が残っているかを明示することで、判断の確からしさを説明できる。
成果の帰属が不明なまま「AIで10%改善した」と表現すると、別の拠点や時期で再現しない可能性が高くなる。
3-4. Accuracy・Precision・Recallは業務の損失構造から選ぶ
AIの分類性能は、単に「精度」という一語では表せない。
| 指標 | 意味 |
|---|---|
| Accuracy | 全判定のうち正しかった割合 |
| Precision | AIが対象だと判定したもののうち、本当に対象だった割合 |
| Recall | 本来対象だったもののうち、AIが拾えた割合 |
| False Positive | 問題のないものを、問題ありと判定した件数 |
| False Negative | 問題のあるものを見逃した件数 |
どの指標を重視するべきかは、誤判定が生む損失によって決まる。
例えば、1万件の中に本当に問題のあるケースが30件しかないとする。すべてを「問題なし」と判定しても、Accuracyは99.7%になる。しかし、問題のある30件をすべて見逃しているため、業務上は役に立たない。
反対に、30件をすべて拾うため、6000件へ警告を出したとする。Recallは100%になるが、人間は6000件を確認しなければならない。この場合、見逃しは防げても、確認工数やアラート疲れによって実用性を失う可能性がある。
Recallを重視する業務では、Recallだけでなく次を同時に見る必要がある。
- Precision
- 警告件数
- 人間の確認時間
- 見逃し一件の損失
- 誤検知一件のコスト
- 人間が確認可能な件数
- アラートが信用され続けるか
また、実際の対象は完全なOK/NGに分かれていないことが多い。
- 明らかなNG
- NGの可能性が高い
- 判断が難しい
- おそらく問題ない
- 明らかに問題ない
AIがどの範囲まで安定して判定できるかによって、実用的な役割は変わる。
明らかなNGだけを高いPrecisionで拾い、早期対応へつなげる使い方もある。すべてのNGを取り切るために広く拾い、その後に二次判定や人間確認を置く使い方もある。
したがって、評価の問いは「精度は何%か」ではなく、次のようになる。
- AIへどの役割を任せるのか
- 何を見逃してはいけないのか
- 何件まで誤検知を許容できるのか
- 人間の作業をどこまで減らせるのか
- どの境界から人間判断へ戻すのか
4. AI処理の内側と生成物を評価するための知識
4-1. 中間表現を持つ場合、値の正しさと構造の妥当性を分ける
生成AIシステムでは、AIの出力をそのまま最終成果物にせず、JSON、構造化データ、DSL、状態表現、計画データなどの中間表現へ変換することがある。
例えば、図面生成システムでは次のような構造になる。
諸元表
↓
AIによる情報解釈
↓
DSL・構造化データ
↓
図面生成ロジック
↓
最終図面
中間表現を置くと、AIが理解した内容を人間が確認できる。生成ロジックを決定的にできる。モデルを変更しても後続処理との接続を維持できる。問題がどこで発生したかを切り分けやすくなる。
ただし、中間表現の評価には二種類ある。
一つは、定義された項目へ正しい値が入っているかという評価である。
- 正しい部品名が入っているか
- 接続先が正しいか
- 数量や属性が正しいか
- 必要な値が欠けていないか
もう一つは、その項目構造自体が業務を表現するために十分かという評価である。
- 必要な業務概念を表現できるか
- 階層や粒度が適切か
- 例外や不明状態を表現できるか
- 複数の要素を組み合わせられるか
- 将来のケースへ拡張できるか
- 人間が読んで修正できるか
AIが正しく理解しても、その情報を保存する変数が存在しなければ、問題はAIの精度ではなく中間表現の設計にある。
反対に、DSLやスキーマが十分でも、AIが誤った値を入れているなら、入力解釈や変換処理の問題である。
さらに、中間表現が正しくても最終成果物が間違っているなら、生成ロジックの問題である。
この区別がないと、すべての不具合に対してプロンプトを変更する、すべての不具合に対してDSLを拡張するといった誤った改善が起こる。
評価設計では、最終出力だけでなく、処理層ごとの入力・出力・責任を見えるようにする必要がある。
4-2. 正解例との差分と、業務上の問題を分ける
生成AIによる文章、図面、計画、要約などには、複数の成立する出力が存在することがある。
そのため、人間が作った正解例と完全に同じでないことを、すべて不正解として扱うと過剰な品質追求が起こる。
例えば図面では、色、配置、線の間隔、ラベル位置が異なっていても、接続関係が正しく、利用者が誤解せず、後工程にも影響しないなら、業務上は許容できる可能性がある。
一方、見た目の差は小さくても、接続関係、金額、責任主体、判断条件などが違えば重大な問題になる。
差分の大きさと、業務影響の大きさは一致しない。
差分は、少なくとも次のように分けて扱う。
| 区分 | 内容 | 扱い |
|---|---|---|
| 致命的問題 | 安全・法令・機能成立へ影響する | Gate・必須修正 |
| 業務上の問題 | 判断・利用・後工程へ支障がある | 優先的に改善 |
| 軽微な品質差 | 利用可能だが望ましくない | 費用対効果で判断 |
| 許容可能な揺らぎ | 意味・機能が同等 | 原則修正不要 |
| スコープ外 | 今回の対象外 | 将来課題として記録 |
| 判断未確定 | 現場知識がなければ判断できない | ヒアリング対象 |
重要なのは、「違いがある」という観測と、「直す必要がある」という意思決定を分けることである。
また、差分への指摘は暗黙知を回収する機会でもある。
評価者が「ここは違う」と言った場合、そのまま修正依頼として処理するのではなく、次を確認する。
- なぜ違ってはいけないのか
- 何に影響するのか
- どの条件なら許容できるのか
- 他のケースにも共通するルールか
- 人間は何を見て判断したのか
この確認によって、単発の修正コメントが、再利用可能な品質基準や業務ルールになる。
5. 評価基準と評価ケースを育てるための知識
5-1. 評価基準自体が、評価を通じて更新される
生成AIプロジェクトでは、評価開始時点から完璧な評価基準が存在するとは限らない。
初期段階では、何が品質を構成しているのか自体が十分に分かっていないことがある。実際の出力を見て初めて、これまで意識されていなかった評価軸が見つかる。
例えば問い合わせ対応AIを評価する中で、当初は「回答内容の正確性」だけを見ていたが、次のような品質要素が追加されることがある。
- 顧客の感情状態への配慮
- 不必要な断定の回避
- 必要な確認質問
- 担当部署への引き継ぎ
- 回答しない方がよい条件
- 契約条件による回答差
この意味で、初期の評価基準は確定した正解ではなく仮説である。
ただし、評価基準を最後まで変更し続けると、結果の比較ができなくなる。初期と後期で採点基準が異なれば、スコアの改善がAIによるものか、採点基準の変更によるものか分からない。
そのため、評価プロジェクトでは探索期と判定期を分ける必要がある。
| フェーズ | 評価基準の扱い |
|---|---|
| 初期探索 | 品質軸を発見・追加・統合する |
| 中間評価 | 定義や例示を具体化し、評価者間ですり合わせる |
| 最終評価 | 原則として基準を固定し、実用化判断に使う |
| 保守評価 | 業務やモデルの変化に応じて改訂する |
評価基準を変更した場合には、変更理由、変更日、適用対象、バージョンを残す。必要に応じて、過去ケースを新しい基準で再評価する。
評価基準が育つこと自体は問題ではない。基準が変わった事実を記録せず、異なる基準の結果を同じ数字として比較することが問題になる。
5-2. 評価ケースは、一度使って終わるサンプルではなく資産になる
評価中に見つかった失敗ケースは、修正が終わった後も残す必要がある。
例えば、特定の言い回しで検索先を間違えた、金銭に関する質問で断定した、曖昧な条件を勝手に補完した、といったケースは、改善後に再度実行することで再発を検知できる。
このような継続確認を回帰評価と呼ぶ。
評価ケースには、複数の役割がある。
- 現在の能力を測る
- 苦手な条件を明らかにする
- 改善後に問題が直ったか確認する
- 別の変更で過去の問題が再発していないか確認する
- モデル変更時の性能差を比較する
- 新しい評価者の判断をすり合わせる
ケース群は、次のような構成で持つとよい。
| ケース群 | 役割 |
|---|---|
| 代表ケース | 日常的に発生する主要業務を確認する |
| 境界ケース | 成立と不成立の境界を確認する |
| 重大ケース | 頻度は低いが、失敗時の影響が大きい |
| 過去失敗ケース | 回帰を検知する |
| バリエーション | 言い回し・条件変更への安定性を見る |
| スコープ外探索 | 将来拡張の難易度を知る |
評価ケースには、入力と期待出力だけでなく、ケースの目的、重要度、条件タグ、正解の出所、過去に発生した問題、評価基準のバージョンを紐づける。
案件が進むほど、評価ケースはその組織固有の品質資産になる。過去の失敗、判断、例外がケースとして蓄積されることで、AIシステムを安全に変更しやすくなる。
一方で、ケースを増やし続ければよいわけではない。実際の母集団と乖離していないか、古い業務ルールに基づくケースが残っていないか、同じ内容が重複していないかを定期的に見直す必要がある。
6. 人間・第三者・組織が評価に関わる意味
6-1. AIによる自動評価だけでは閉じない領域がある
大量の出力を評価する場合、別のAIを評価者として用いる方法は有効である。一定の基準で大量処理でき、人間が全件を見るより速く、評価コストを下げられる。
一方、AIによる自動評価だけでは決められないこともある。
- 組織として許容できる表現か
- 顧客との関係を損なわないか
- 業務上の責任を持てる判断か
- どの差分を問題として扱うか
- 例外的なケースで何を優先するか
- 数字に表れない価値をどう扱うか
これらは、単純な正解判定ではなく、組織や事業の価値判断を含む。
また、AI評価者自体も誤る。文章の流暢さへ引っ張られる、長い回答を高く評価する、特定の言い回しを好む、評価指示を十分に守らない、といった偏りが起こりうる。
そのため、自動評価を使う場合にも、少なくとも次が必要になる。
- 人間が作った評価基準
- 人間評価との一致確認
- 境界ケース・重大ケースの人間確認
- 評価AIのバージョン管理
- 自動評価が苦手なケースの把握
- 定期的な再較正
人間の評価も自動的に正しいわけではない。評価者によって判断が異なる場合があるため、判断基準、具体例、許容例、NG例を揃える必要がある。
つまり、AI評価と人間評価は代替関係ではない。AIは規模と一貫性を補助し、人間は基準、責任、境界判断、意味づけを担う。
6-2. 第三者評価の意味は、別会社が数字を測ることではない
第三者評価という言葉は、外部企業が評価を行うことだと理解されやすい。しかし、組織が外部であることだけでは十分ではない。
実装者が設定した指標を、別会社がそのまま測るだけであれば、評価の前提は実装側と変わらない。
第三者性の中心は、次の問いを独立して持てることである。
- その指標を満たすことが本当に事業目的を意味するか
- 評価対象の切り方は正しいか
- 比較対象は妥当か
- 重要な失敗条件が抜けていないか
- 実装側に都合のよい母集団になっていないか
- 測れない範囲が隠れていないか
- 別の簡単な方法で同じ成果が得られないか
例えば、「誤差を±10%以内にする」という既存条件があったとしても、第三者評価では、その数字を正確に測るだけでなく、「±10%以内なら業務として使えるのか」「±10%を超えても業務上問題がないケースがあるのではないか」を確認する。
第三者は、プロジェクトを否定する役割ではない。発注者、実装者、現場がそれぞれ持つ前提を並べ、正しい意思決定ができる状態を作る役割である。
また、第三者が正しく機能するには、実装者から提供された情報だけで評価しないことも重要になる。現場、意思決定者、データ保有者、法務・安全担当などから直接情報を得られる構造が必要になる。
第三者評価は外部性だけでなく、前提からの独立性と情報経路の複数性によって成立する。
6-3. 評価には、組織の品質基準を言語化する作用がある
AIを評価しようとすると、AI側だけでなく、人間側の曖昧さも表面化する。
例えば複数の評価者へ同じ回答を見せたとき、一人は問題ないと判断し、別の人は重大な問題だと判断することがある。
この不一致は、評価者の能力不足とは限らない。組織内で次のことが決まっていない可能性がある。
- どこまで断定してよいか
- どのケースで確認質問をするか
- 何を顧客へ伝えてはいけないか
- どの程度の表現差を許容するか
- 例外時に何を優先するか
- 誰が最終責任を持つか
人間同士は、曖昧なルールでも経験や空気によって仕事を成立させられる。しかしAIへ仕事を渡すには、その曖昧さを一定程度言語化する必要がある。
評価の過程で行われる議論は、AIの採点だけではない。
- 良い仕事とは何か
- 許容できない失敗は何か
- 現場では何を見て判断しているか
- 例外時の優先順位は何か
を組織として定める作業になる。
したがって、評価プロジェクトの成果には、スコアだけでなく次のようなものも含まれる。
- 品質基準
- 評価ルーブリック
- 例外ルール
- 判断例
- NG例
- 業務マニュアル
- 人間とAIの役割分担
- 責任範囲
AI評価は、組織がこれまで暗黙に扱っていた品質を、共有可能な形へ変換するプロセスでもある。
7. 評価プロジェクトを正しく進めるための知識
7-1. 評価資料は、相手の思考を起動するために使う
評価資料は、常に完成度が高いほど良いわけではない。プロジェクトの段階によって、資料が担う役割は変わる。
初期段階では、詳細なKPIやリスク一覧を完成させるより、次について相手の知識を引き出すことが重要になる。
- 業務理解に誤りがないか
- 本当に明らかにしたいことは何か
- 何が起きると実用化できないか
- 現場でしか分からない失敗条件は何か
- まだ把握できていない情報は何か
設計者が非常に具体的で完成度の高い仮説を提示すると、相手は「それでよいです」と答えやすくなる。しかし、その同意は本当に必要なものへ到達した証拠とは限らない。相手がそれ以上考えなくても済むほど、案が強く見えているだけの場合がある。
特に初期のレビュー資料では、次を明示する必要がある。
- 現時点の仮説
- その仮説を置いた理由
- まだ分からないこと
- 相手に確認したいこと
- 相手の知識が必要な場所
良い資料は、すべてを説明して終わる資料ではない。読み手が「実際にはこういうケースがある」「この前提は違う」と考え始める資料である。
また、全リスクを平等に並べるより、設計者が主要だと考えているリスクを先に示した方がよい。
現時点では、特にこの3点を重要と考えています。この重み付けは妥当でしょうか。
という形で置けば、相手は重要度について意見を返しやすい。
初期の資料は相手から知識を引き出すためのもの、詳細設計書は実行方法を固定するためのもの、最終レポートは意思決定を行うためのものとして分ける必要がある。
7-2. 解決策を示す前に、回避したい失敗を共有する
プロジェクトの途中で、当初の目標や進め方に問題があると気づくことがある。
例えば、精度向上を続けても現場で使われる場面が見えない、全件自動化を目指すことで実用化が遠ざかっている、現在のKPIを達成しても事業成果が変わらない、といった状態である。
このとき、いきなり新しいゴールや実装案を提示すると、相手には支援側の都合や方針変更に見えることがある。
必要なのは、先に回避したい未来を共有することである。
現在のまま進めてもシステムは完成します。しかし、完成後に実際の業務で使われない可能性があります。
精度は上がりますが、現場の確認作業が残るため、業務量はほとんど減らない可能性があります。
対応ケースを増やし続けると、基礎構造が固まらず、PoC終了時に実用範囲を説明できない可能性があります。
こうした失敗像について相手も問題だと認識できれば、ゴールや進め方の変更が共同作業になる。
リスク共有では、次の順序が有効である。
- このまま進んだ場合に起こりうること
- なぜそう考えているか
- 起きた場合の事業・業務上の影響
- まだ不確実な点
- 回避するための選択肢
解決策から話すと、相手は提案へ賛成するか反対するかを考える。リスクから話すと、まず現実認識を共同で作ることができる。
7-3. AI開発は安くなったからこそ、不要なものを作りやすい
生成AIによって、試作品を作るコストは大きく下がった。以前なら数カ月必要だった実装が、数日や数週間で動くこともある。
これは大きな利点だが、同時に別のリスクを生む。
作ることが簡単になると、「本当に必要か」を考える前に実装が始まりやすい。
- とりあえず作る
- 精度を見てから考える
- 使われなければ別のものを作る
- 機能を追加しながら目的を探す
この進め方では、制作活動そのものがプロジェクトの進捗に見える。実際には、何を学ぶための試作なのか、どの意思決定へつなげるのかが定まっていないため、成果へ近づいているとは限らない。
また、試作コストが低くても、組織が負担する総コストは低いとは限らない。
- 現場が説明する時間
- データを準備する時間
- 評価する時間
- システムへ接続する費用
- 利用者を教育する時間
- 使われない仕組みを保守する費用
- 他の施策を行えなかった機会損失
が発生する。
したがって、小さく作る場合にも、少なくとも次を先に定める必要がある。
- この試作で何を確かめるのか
- どの不確実性を減らすのか
- どの結果なら次へ進むのか
- どの結果なら方式を変えるのか
- どの結果なら止めるのか
- 何を作らないのか
小さく作ることと、目的なく作ることは違う。
AI開発が安くなったことで、実装は探索手段として使いやすくなった。しかし、探索として使うには、何を観測するための実装かが必要になる。
評価設計の役割は、開発速度を落とすことではない。速く作れる環境の中で、不要なものを繰り返し作らず、実装から得られる学習を次の判断へ接続することである。
この全体像を貫く考え方
生成AI・LLMの評価設計では、AIに点数を付けることだけを考えてはいけない。
実際に扱うべきなのは、次の関係である。
AIの能力
×
入力データ
×
人間の判断と行動
×
既存システム
×
業務上の制約
×
対象となるケース
=
実際の業務成果
同じAIでも、データ、人間、業務、対象条件が変われば結果は変わる。そのため、「AIは使えるか」という一つの問いだけでは、実用性を正しく表現できない。
評価によって明らかにするべきなのは、次のような状態である。
- AIは何ができるのか
- 何ができないのか
- どの条件で成果が出るのか
- どの条件で失敗するのか
- 失敗の原因はどこにあるのか
- 人間の補完はどこまで必要か
- どの範囲なら責任を持って使えるのか
- 何を改善すれば利用範囲を広げられるのか
- 現実的な代替案と比べてAIを使う意味があるのか
- 次に継続、改善、限定導入、拡大、停止のどれを選ぶべきか
評価が成功した状態とは、AIが高いスコアを取った状態ではない。
何ができ、何ができず、なぜその結果になり、どの条件なら現実の仕事を任せられるのかを、関係者が誤解なく判断できる状態である。
最後に
生成AI・LLMの評価は、完成したシステムへ点数を付ける作業ではない。
評価を通じて、
- 何を品質と呼ぶのか
- AIは何ができるのか
- 何ができないのか
- 人間は何を担うべきか
- 業務はどこまで変えられるのか
- どこで失敗するのか
- 何を直せば次へ進めるのか
を明らかにしていく仕事である。
だから評価の最終成果は、精度90%という数字ではない。
「この条件なら使える。この条件ではまだ使えない。使えない理由はこれで、ここを改善すれば次へ進める。その判断には十分な証拠がある」
と説明できる状態である。
生成AIの評価設計とは、AIを採点する技術ではない。
AI・人間・業務・データ・組織が混ざった現実を誤認せず、実用可能な状態へ近づけるための技術である。