この知恵で考えられること
AIモデルの性能を向上させるために、一般的に「追加学習(ファインチューニング)」が用いられます。しかし、追加学習に用いた個々のデータが最終的な学習結果にどれだけ貢献したのかを正確に特定することは非常に難しい課題です。
AIモデルの性能を向上させるために、一般的に「追加学習(ファインチューニング)」が用いられます。しかし、追加学習に用いた個々のデータが最終的な学習結果にどれだけ貢献したのかを正確に特定することは非常に難しい課題です。
この課題を具体的に説明するために、2枚のスライドを活用しながら解説します。
一般的な追加学習モデルの課題
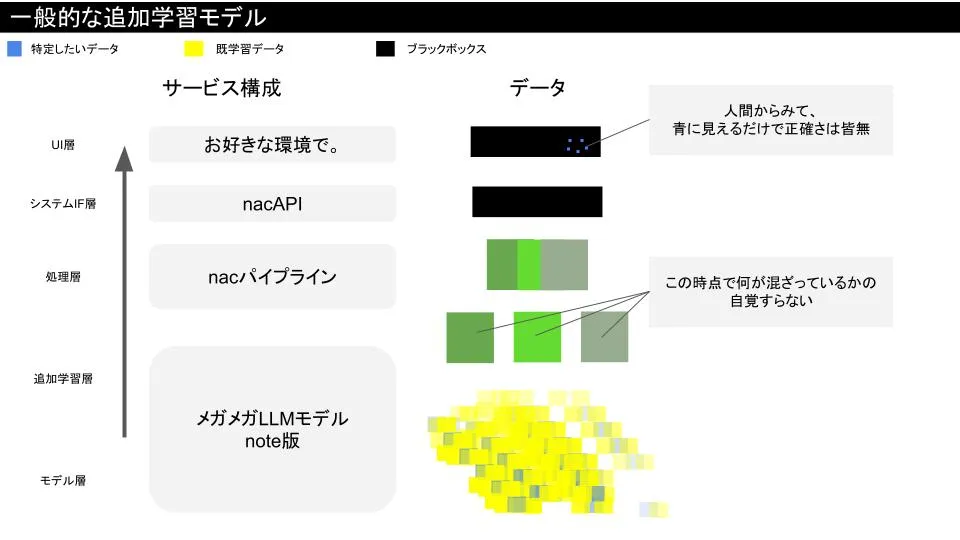
このスライドは、従来の追加学習モデルのサービス構成とデータ構造を示しています。
- モデル層は「メガメガLLMモデルnote版」として大きなブラックボックス化しています。
- 追加学習層には、膨大な既学習データ(黄色)が混在しており、新しく追加する特定データ(青色)もこの中へ組み込まれます。
- しかし、どのデータがモデルに対してどの程度寄与したのかを可視化できません。スライド内のコメントにもあるように、「人間からみて、青に見えるだけで正確な貢献度はまったく分からない」のが現状です。
このように、モデル内部が「ブラックボックス」であること、データが混ざり合っていることによって、個別データの貢献度の特定は非常に困難です。
提案するデータ単位の貢献特定構成
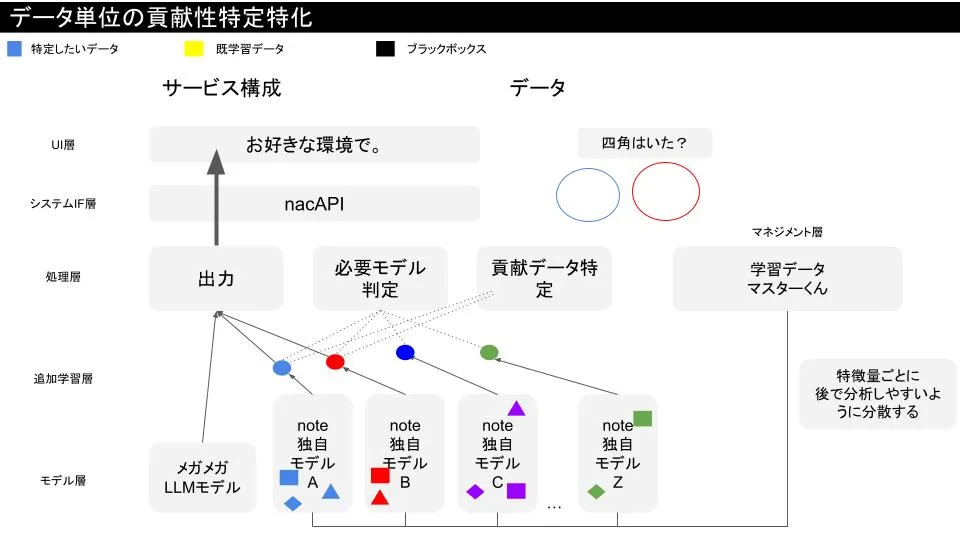
一方、このスライドは提案する新たなサービス構成を示しています。
- モデル層には複数の「note独自モデルA,B,C,Z…」を配置し、各モデルが特定のデータセットに対応しています。ここでの特長はデータ単位で担当モデルを分けることです。
- 追加学習層では、それぞれのモデルに対応した追加データ(青や赤の丸などで示されている)が明確に管理されています。
- さらに「貢献データ特定」層が設けられており、ここで各追加学習データの貢献度を解析可能にする仕組みを持たせています。
- 最終出力は「メガメガLLMモデル」に集約されますが、複数モデルからの寄与を明示的に評価できるため、従来のブラックボックス的な「既学習データのごちゃまぜ」状態から脱却しています。
また、マネジメント層に「学習データマスターくん」を置き、特徴量ごとにデータを分散・管理する設計もポイントです。これにより「どの特徴量にどれだけ貢献したか」という詳細分析も進めやすくなります。
なぜ処理方法からの見直しが必要になるのか?
従来モデルでは、追加学習の過程とデータ管理がブラックボックスとして扱われており、学習データ単位での影響度の特定は原理的に難しいものでした。そこで、
- データの分散管理
- モデルを複数に分割
- 貢献度を解析するための仕組み構築
というサービス全体の設計から改める必要があります。
こうした構造変革により、単にモデルの精度を上げるだけでなく、どのデータがIA性能向上に寄与したかを「見える化」できるようになり、学習効率のさらなる最適化や説明性の強化に繋げられます。
他の一般的な方法論と適用シーン
1. シャープレイ値(Shapley Value)を用いた貢献度解析
概要
ゲーム理論に由来するシャープレイ値は、複数の参加者(この場合、学習データ)それぞれが最終成果(モデルの性能)にどれだけ貢献したかを公平に評価する手法です。複数のデータの組み合わせを試行的に学習させ、その性能差から貢献度を割り出します。
適用例・目的
- 目的:学習データごとの貢献度を定量的に評価し、不要または逆効果なデータを検出・排除したい場合。
- 業種:金融(コンプライアンス重視でデータの説明責任が必要な場面)、医療(データの正確性・重要度評価が必須な研究開発)。
- 意図:透明性と説明性を高め、学習データのクリーンアップやリスク管理を目的とするときに有効。
制約
- 計算コストが非常に高い。大規模モデルや大量データには適用が難しい場合がある。
2. 層別分割とモデルアンサンブルによる寄与解析
概要
事前にデータを属性(例えば年代別や地域別など)で分割し、それぞれに特化したサブモデルを構築。これらをアンサンブルして全モデル成果を得る。各データグループの寄与は、各サブモデルの性能貢献度で評価する。
適用例・目的
- 目的:特定セグメントのデータがモデル性能にどう影響しているかを具体的に測りたい場合。
- 業種:マーケティング(顧客層ごとの影響を測定)、製造業(機械ごとやラインごとの故障データ評価)。
- 意図:セグメント毎の特性把握やターゲティングのための貢献度解析に適している。
制約
- データの分割軸を適切に選定する必要があり、分割数が多いと管理が複雑になる。
3. インフルエンス関数を使った微分的貢献解析
概要
モデルの微分情報を使い、単一データ点を学習セットから除いた際にモデルのパラメータや損失関数がどのように変化するかを推定する手法。高速に近似的な影響を算出できる。
適用例・目的
- 目的:大規模データセットで、特定データがモデル性能に与える影響をリアルタイムで評価したい場合。
- 業種:Eコマース(レビューや取引履歴の影響分析)、SNS解析(投稿データの影響評価)。
- 意図:動的にデータの品質管理や異常検知を行う際に活用できる。
制約
- 近似計算のため誤差が生じやすく、複雑なモデルほど結果の信頼性に注意が必要。
4. データプルーニング(Data Pruning)と逐次評価
概要
追加学習前後でモデル性能を比較し、不必要と思われるデータを削減しながら再学習を繰り返す手法。貢献度は間接的に性能向上の差分で評価。
適用例・目的
- 目的:ストレージ・学習コストを削減しつつモデル性能を維持・向上させたい場合。
- 業種:IoT(センサーデータの省メモリ化と効率化)、モバイルアプリ(ユーザーデータ最適化)。
- 意図:効率重視、かつモデル性能維持が重要なシステムにマッチ。
制約
- 貢献度を直接計測するわけではないため、細かい説明性は得られにくい。
選択のポイントまとめ
| 方法論 | 目的/意図 | 業種例 | メリット | デメリット |
|---|---|---|---|---|
| シャープレイ値 | 公平で精緻な貢献度評価 | 金融、医療 | 高い説明性、理論的根拠あり | 高コスト、大規模には非現実的 |
| 層別分割+アンサンブル | セグメントごと影響評価 | マーケティング、製造 | セグメントごとの詳細分析が可能 | 分割管理が複雑 |
| インフルエンス関数 | 高速な近似影響推定 | Eコマース、SNS | リアルタイム応答可能 | 近似誤差あり |
| データプルーニング+逐次評価 | コスト削減とモデル維持 | IoT、モバイル | コスト面に優れる | 直接的な貢献度は不明確 |
元の提案方法の良さ・メリット
1. データごとに明確に分散管理された構造設計
- 学習データを「note独自モデルA、B、C、Z…」のように複数モデルに分散し、それぞれが担う範囲を明確化。
- これにより、個別データの貢献度を「どのモデルがどう貢献したか」という視点で分かりやすく解析可能。
- 一括で巨大なブラックボックスに突っ込む従来型と異なり、「どこから何が効いているか」が追いやすい。
2. 貢献度解析レイヤーの設置による詳細分析
- 「貢献データ特定」層を設けることで、モデルへの寄与を後から特定・解析しやすい仕組みを設計段階から組み込んでいる。
- データ寄与を「既存データ」と「新規追加データ」とで区別でき、人間に見える形で貢献度を整理可能。
3. サービス全体設計としての包括性
- UI層からモデル層まで全体構成を見据えた設計で、解析・活用環境も「お好きな環境で使える」柔軟性を確保。
- 学習データマスターが特徴量ごとにデータを分散管理することで、切り口を変えた多角的な貢献分析ができる。
4. ブラックボックス化の部分を最小化し、説明性・追跡性を重視
- 特に企業でのAI活用においては、学習データの寄与を説明できることが運用上・法規制上も重要なポイント。
- 元提案はこの点で「データ貢献特定」をサービス設計の中心に置くことで、他の多くの方法よりも透明性・管理性を高めている。
他の方法論との比較での優位点
| 比較軸 | 元提案のメリット | 他方法との違い・優位性 |
|---|---|---|
| 説明性・透明性 | モデル単位で寄与を明示化し、可視性が高い。 | シャープレイ値は理論的だが計算困難、インフルエンス関数は近似的。 |
| スケーラビリティ | 複数モデル分割によって巨大モデルのブラックボックスを分割可能。 | シャープレイ値は大規模に不向き、プルーニングは貢献特定が曖昧。 |
| 柔軟性・拡張性 | UIからAPI、処理層まで総合的なサービス構成で拡張しやすい。 | 層別分割は適切なグルーピングが必要で運用負荷が増す場合がある。 |
| 運用性・管理性 | 学習データマスターにより特徴量ごとの分析も可能で運用管理がしやすい。 | 静的評価のみだと動的環境での管理は難しいケースがある。 |
| 対応業種・拡張適合性 | 金融・医療など説明性重視業種にも、マーケティングなど多分野にも対応可能。 | 他手法は特定業種や規模感に応じて使い分ける必要があることが多い。 |
LLM(大規模言語モデル)とAI追加学習の技術的背景
1. LLMの基本構造と学習の特徴
大規模言語モデル (LLM) とは
LLMは数十億〜数千億に及ぶパラメータを持つディープニューラルネットワークで、膨大なテキストデータから自然言語のパターンや文脈を学習します。代表例としてOpenAIのGPTシリーズやGoogleのBERT、MetaのLLaMAなどがあります。
自己教師あり学習
LLMの学習は主に自己教師あり学習で行われ、テキストの次の単語を予測するタスクを大量のテキストで繰り返します。これにより、文法や世界知識、推論能力をモデル内に暗黙知として蓄積します。
パラメータの巨大さとブラックボックス性
- LLMのパラメータ数は数百億~数千億で、各パラメータがどの入力特徴のどの部分にどう影響しているかは直感的には分かりにくい「ブラックボックス」です。
- 膨大なパラメータの組み合わせによって最終的な応答や結果が決まるため、個別の入力やデータサンプルが学習結果にどのように貢献しているかを単純に追跡することは困難です。
2. 追加学習(ファインチューニング)の役割と課題
追加学習の概要
- 事前学習済みのLLMに対して、特定業務・用途に合わせた少量の追加データで再調整を行い、性能や応答品質の最適化を図るのが「追加学習(ファインチューニング)」です。
- これにより、汎用的な言語能力を持つモデルを、特定ドメイン向けの専門的な知識や表現に特化させられます。
追加学習の難しさ
- 大規模モデルでは一括再学習にかなりの計算コストがかかるため、追加データがどの程度性能向上に寄与しているかを評価することは困難です。
- 特に多数の追加データを扱う場合、その中のどのデータが「役立った」か、「悪影響を及ぼした」かを個別に特定するのは難しい。
- 既存モデルのパラメータと新しいデータが複雑に混ざり合い、どのデータサンプルが結果にどれだけ影響しているのか、ブラックボックスになってしまうのです。
3. なぜ個別データの貢献度特定が重要か
AIの運用と説明責任
- 実務でAIを使う際は「なぜ、その回答や判断が出たのか」「どのデータに基づいているのか」という説明性が求められます。
- 特に金融・医療・公共分野では、学習や判断の根拠をトレースできることが法令遵守や信頼獲得に直結します。
モデル改善と品質管理
- 追加学習に用いたデータの中には、誤情報やノイズ、古いデータが混入することもありえます。
- これらがモデルの性能や応答品質を低下させないか、逆に有益なデータなのかを評価し、継続的にデータセットを整備することが重要です。
効率的なリソース活用
- 大規模モデルの追加学習は計算リソースや時間がかかるため、貢献度の高いデータに絞ることで学習効率を最大化したい。
- 不要なデータを排除することでコスト削減も可能となります。
4. 技術的な背景と限界
ブラックボックスの壁
- LLMの中間層には膨大な特徴ベクトルや重みがあり、単一の入力データとの因果関係は明示化困難。
- 既存学習データや追加学習データがモデルパラメータに及ぼす影響は複雑に絡み合い、「どのパラメータがどのデータの影響を受けたのか」は現在の技術でも正確に追うのは難しい。
既存の貢献度解析手法の背景
- ゲーム理論的評価(シャープレイ値)や微分的影響関数など先端技術は存在するものの、大規模モデル・大規模データセットへのスケーラビリティや計算負荷は課題。
- そのため、「システム設計」や「モデル構造」から改良し、解析可能な形でデータ管理・モデリングを行うアプローチが注目されています。
結論
元提案の大きな価値は、
「サービス全体の処理構成を根本から見直して、データ単位の貢献特定という課題をシステム設計レベルでクリアし、透明性と運用性を両立させている点」にあります。
- 追加学習を単なる性能向上手段で終わらせず、「どのデータがどれだけ役立っているか」を明確に把握・管理したいニーズに対し、批判的に入り込める構造を用意。
- 大規模ブラックボックスに頼ることなく、「分析可能なブラックボックス化の最適化」を図る先進的なアプローチと言えます。
この点で、説明責任が増す現代のAI運用において非常に有用かつ差別化要素の高い戦略的な提案と言えるでしょう。
もし詳細な技術的検討や業務適用例の具体化が必要であれば、さらに深掘りも可能です。