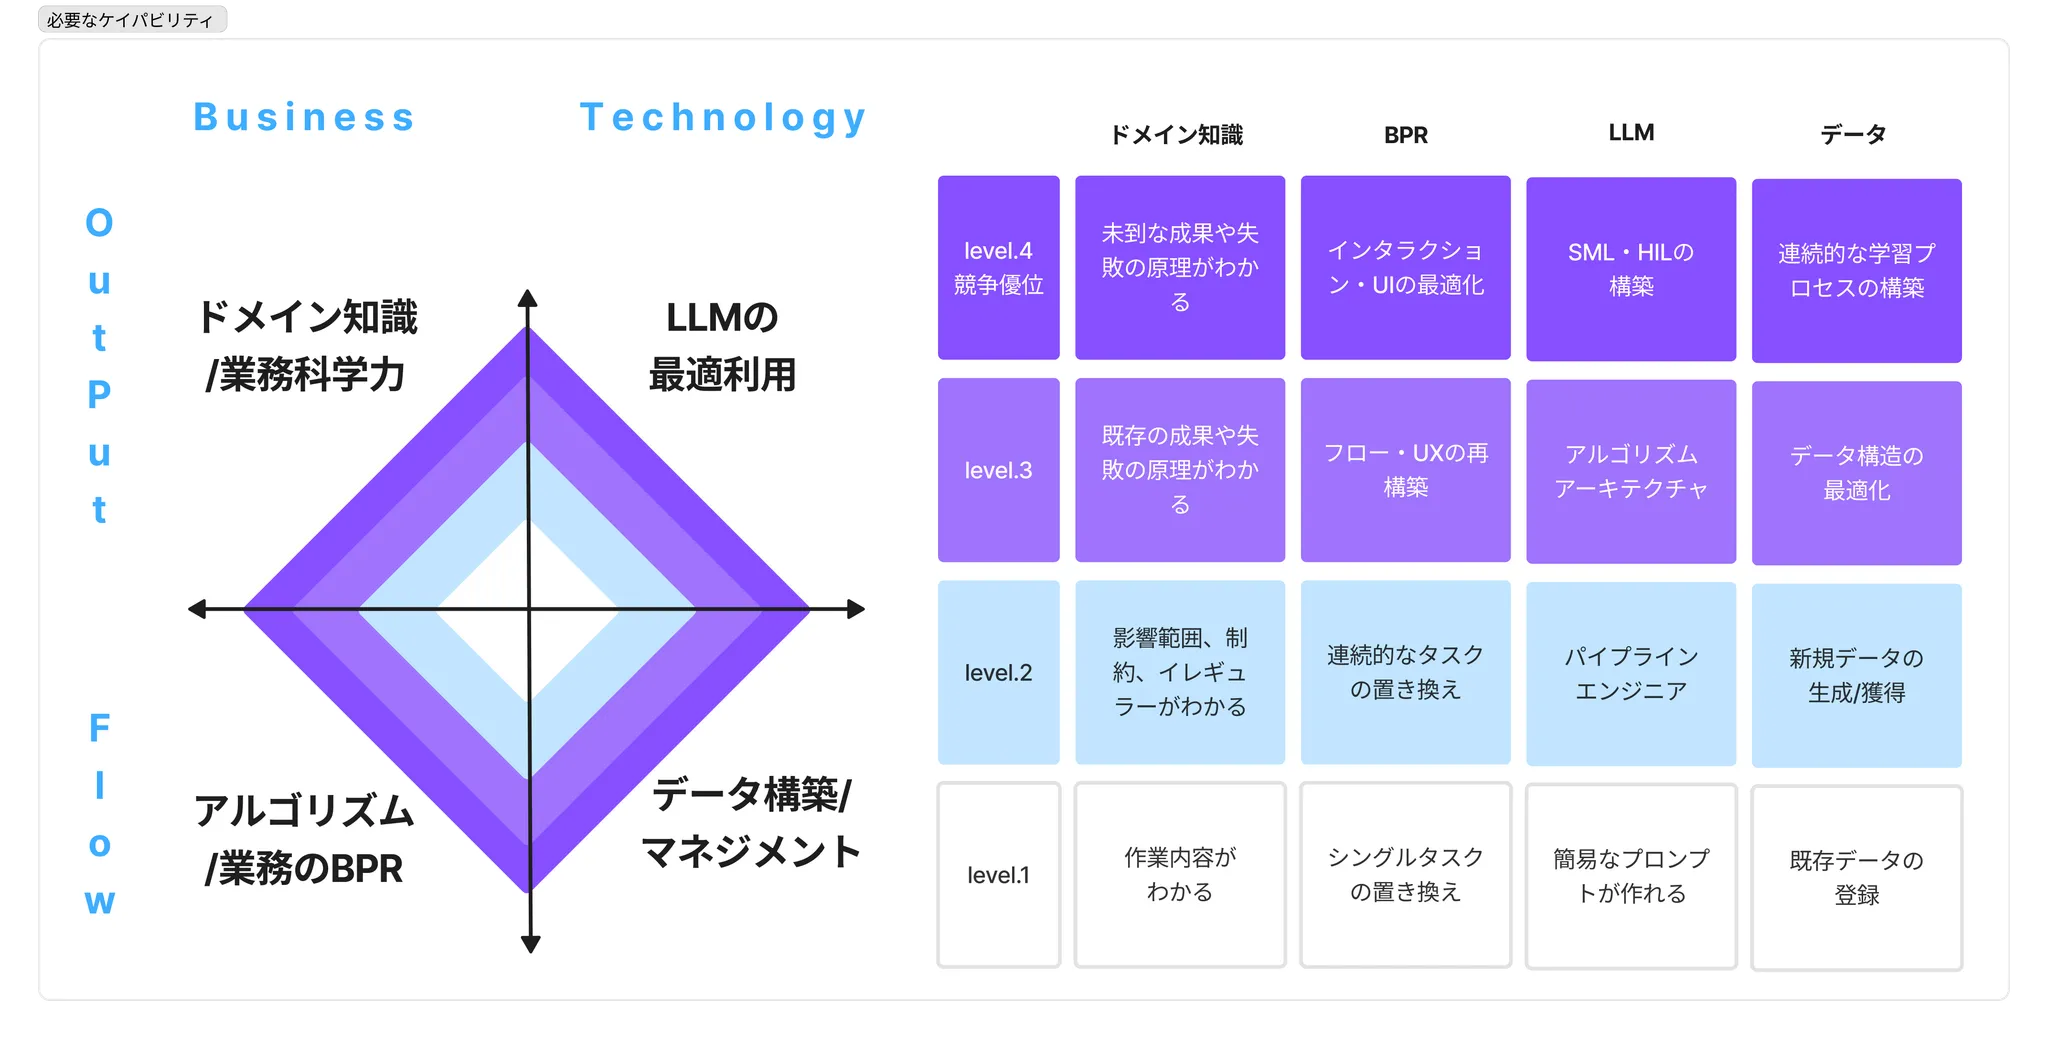
この知恵で考えられること
- 国内初、上場企業に対するGoogleからの出資がありました!盛り上がり中!
自己紹介など
自己紹介など
note株式会社(note AI creative)
- 国内初、上場企業に対するGoogleからの出資がありました!盛り上がり中!
Senko Takeshi (専光 建志)
AI関連のプロダクト/共同研究などの統括およびプレイヤー
ネットプロテクションズ/CAMPFIREなどでPO/PMMしてた
2019年よりLLMの会社のELYZAへ正社員2名の時に入った。
ブランドポジション構築とプロダクトの構築をやってました。
AIチームの立ち上げ屋さんをやっています。
実データや実プロジェクトに近い環境条件でのトレーニングの提供や
組織に入って、丸っと並走や実務内での教育などをしてます。
- 難易度が高いものやカオスなフェーズなどは自分で作ることも今も多々あります。
主幹として自分で作っていたプロダクト
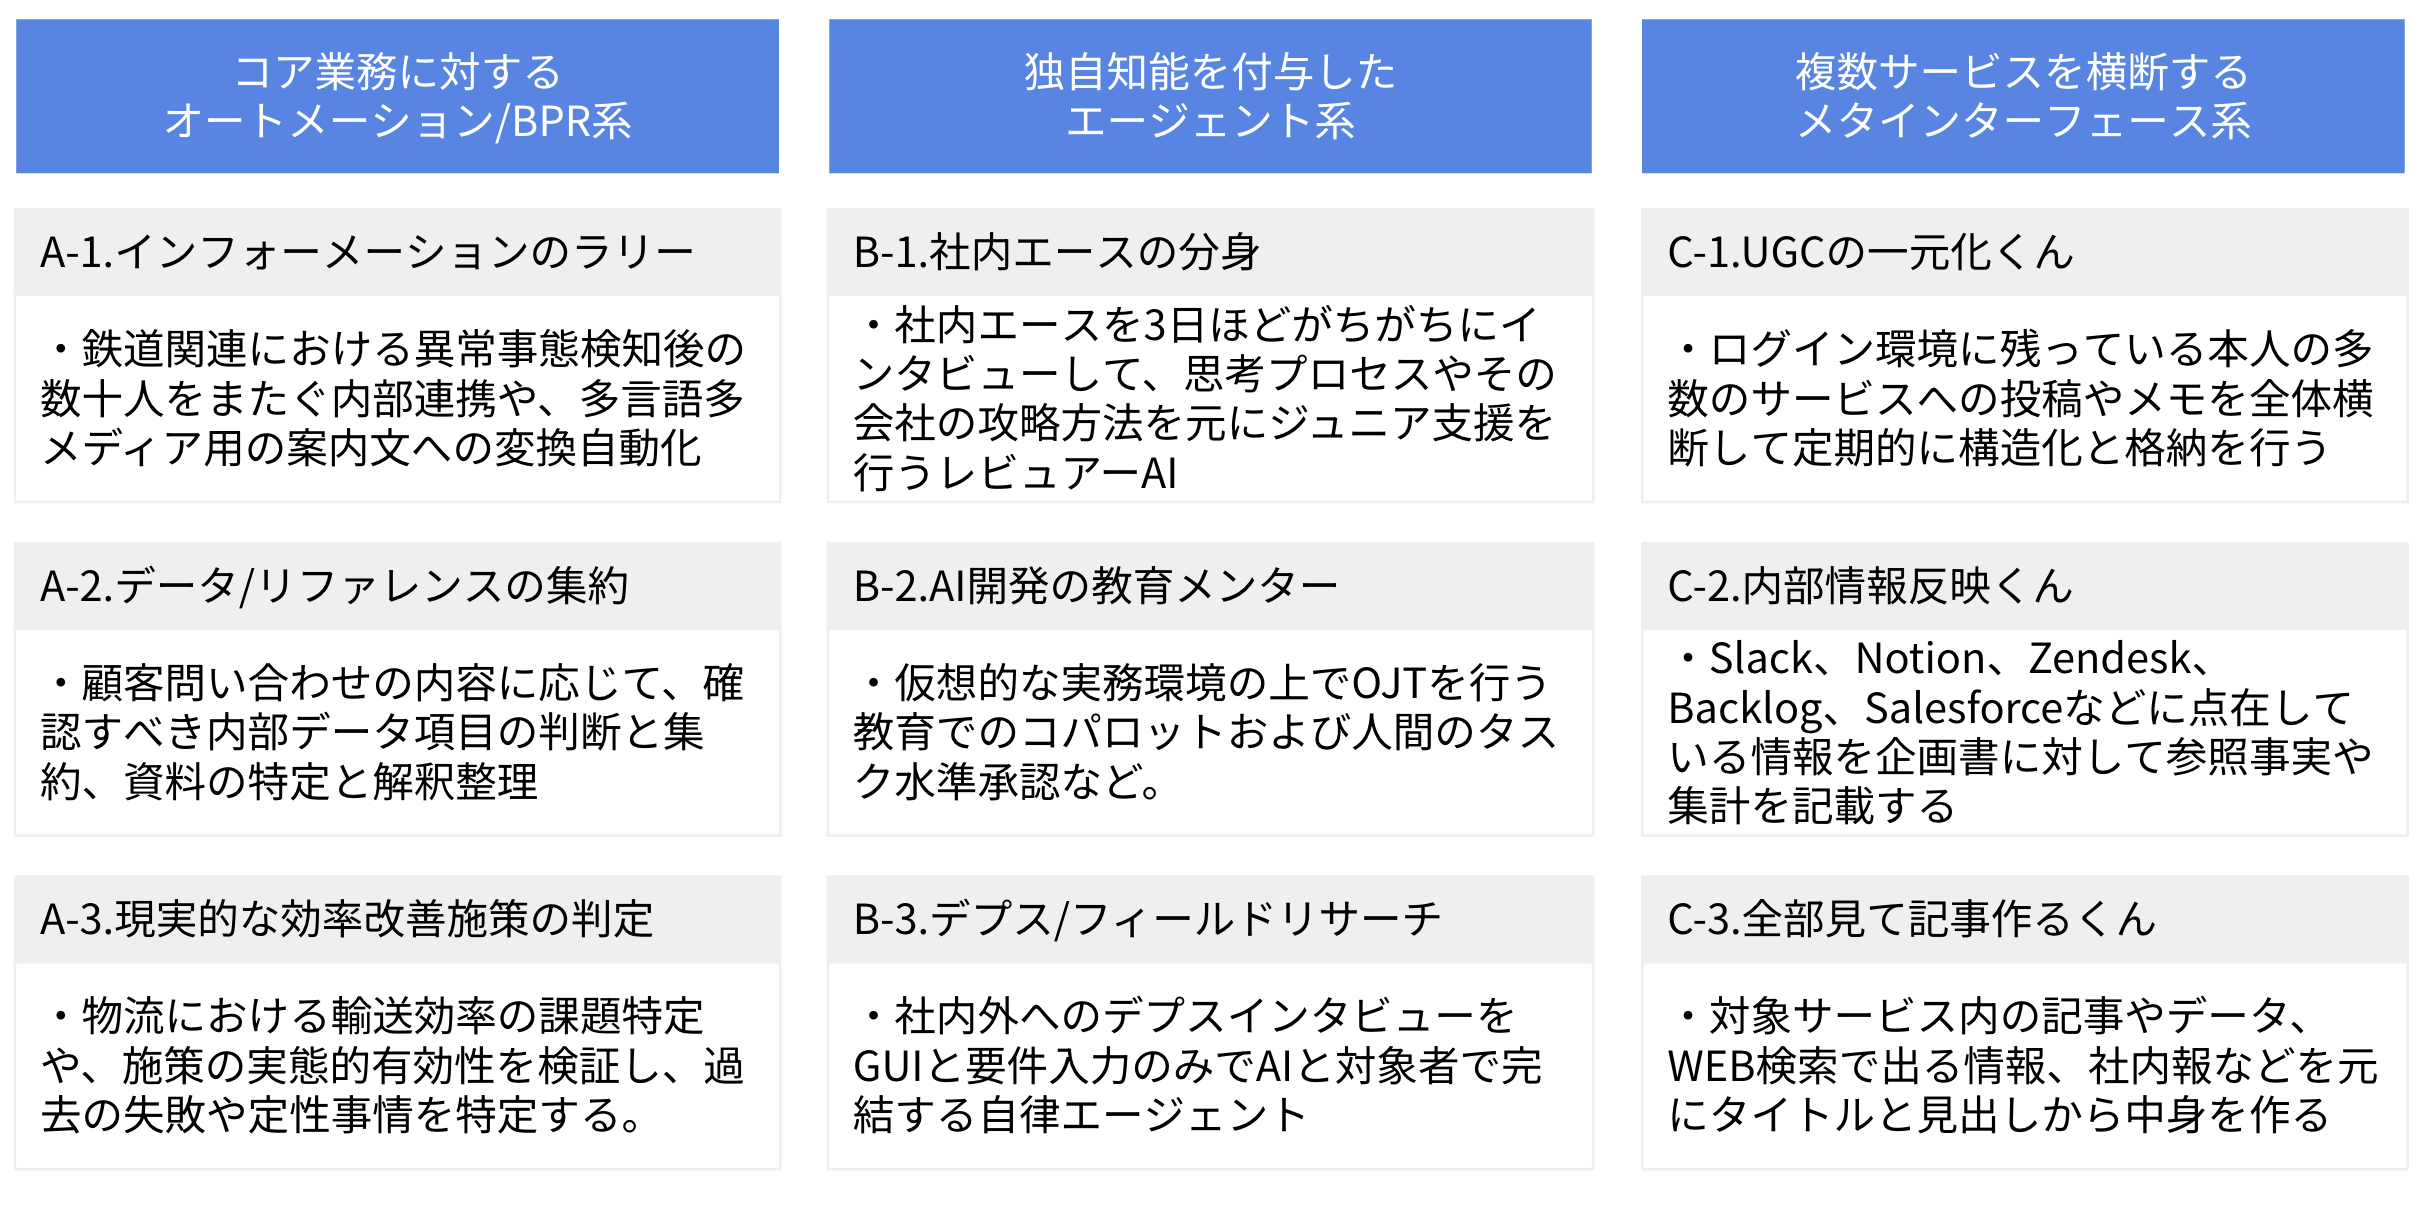
機会があったらイベントでしゃべりたいなと思ってたこと。
LLMを使ったAIサービスを作る仕事の主役は、明らかにエンジニアではない。
- 2019年から5年ほど生成AIに関わってきてこともあり、すごい思います。
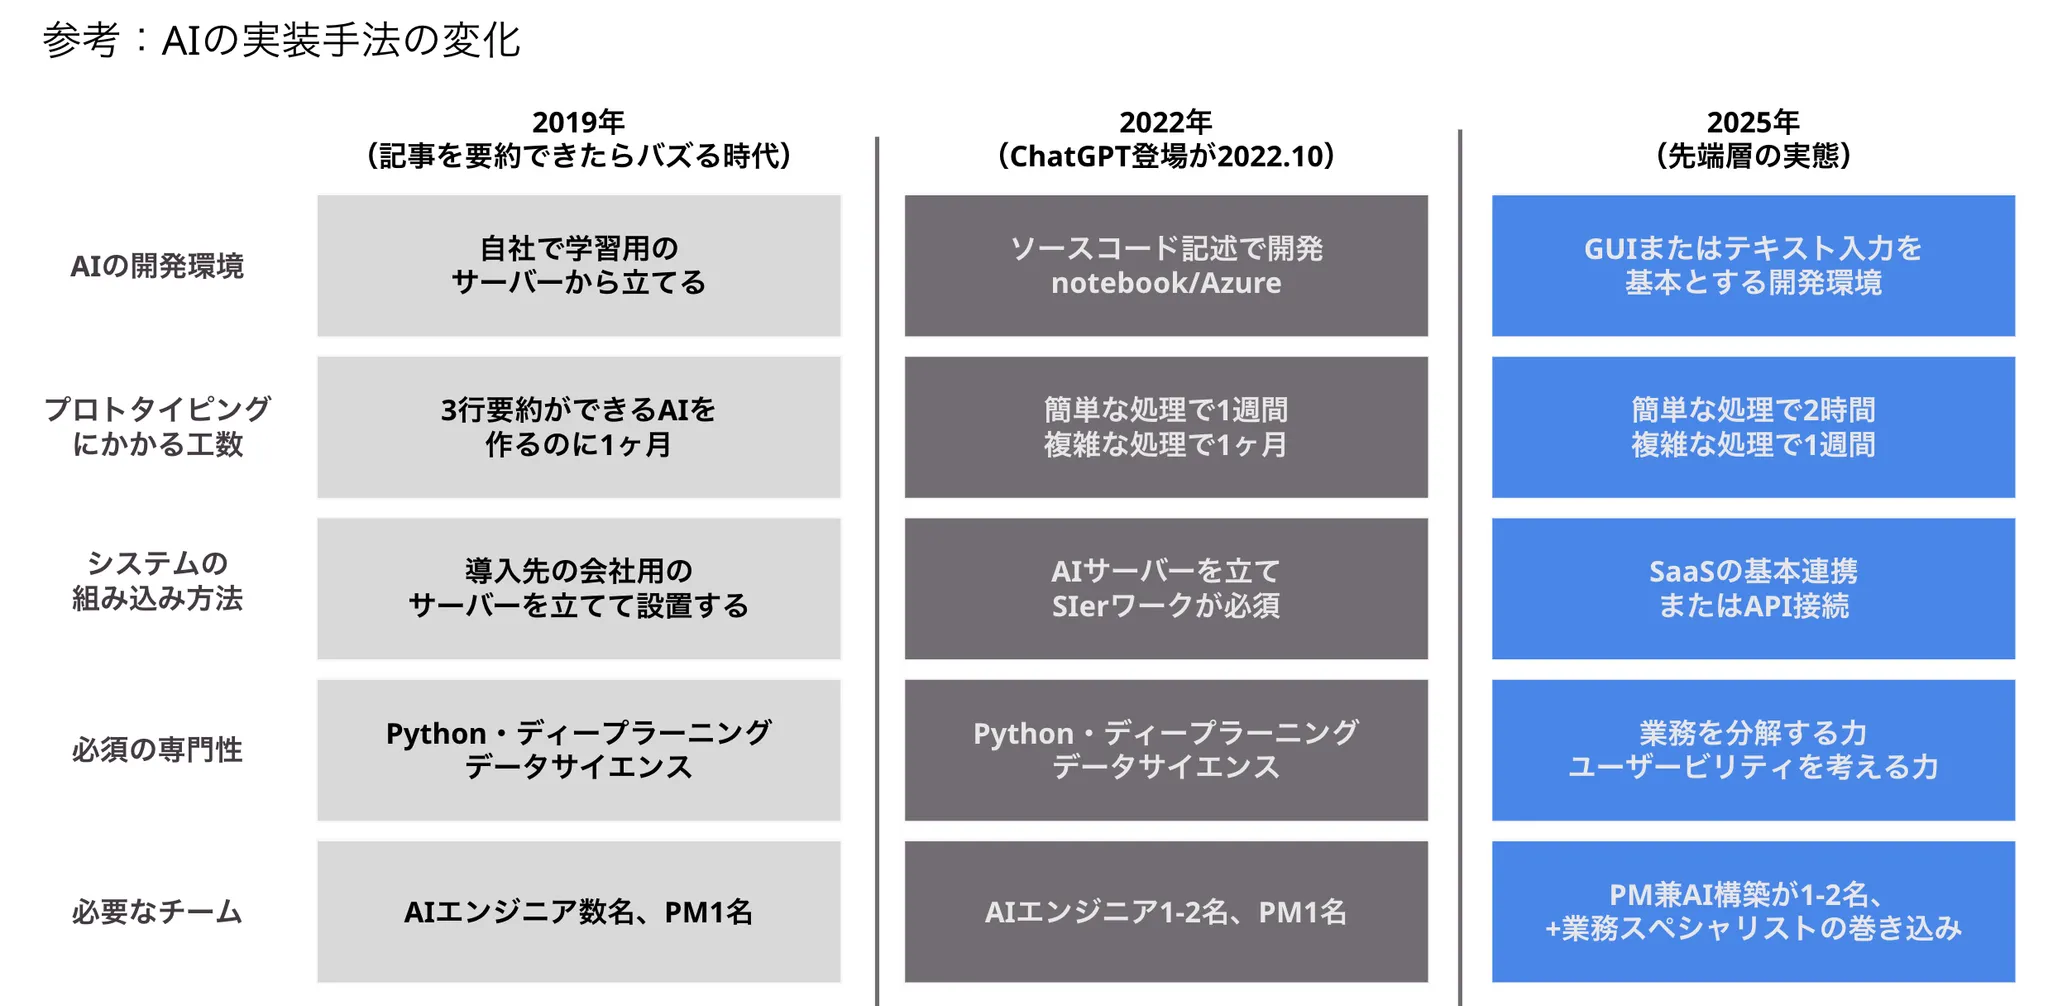
LTのテーマ
生成AI開発におけるスクラム運用戦略~調査・設計・体験設計のプロセスと深化~
要は、「どんなチームがAIで成果を出すのか?」
note社で実践したこと
直近3ヶ月で、組織へ導入したAIの作り方
以下、具体例です。
具体例を共有する上でのテーマ例
「良い記事を判定したい。」 ≒ 品質の低い記事を足切りしたい。
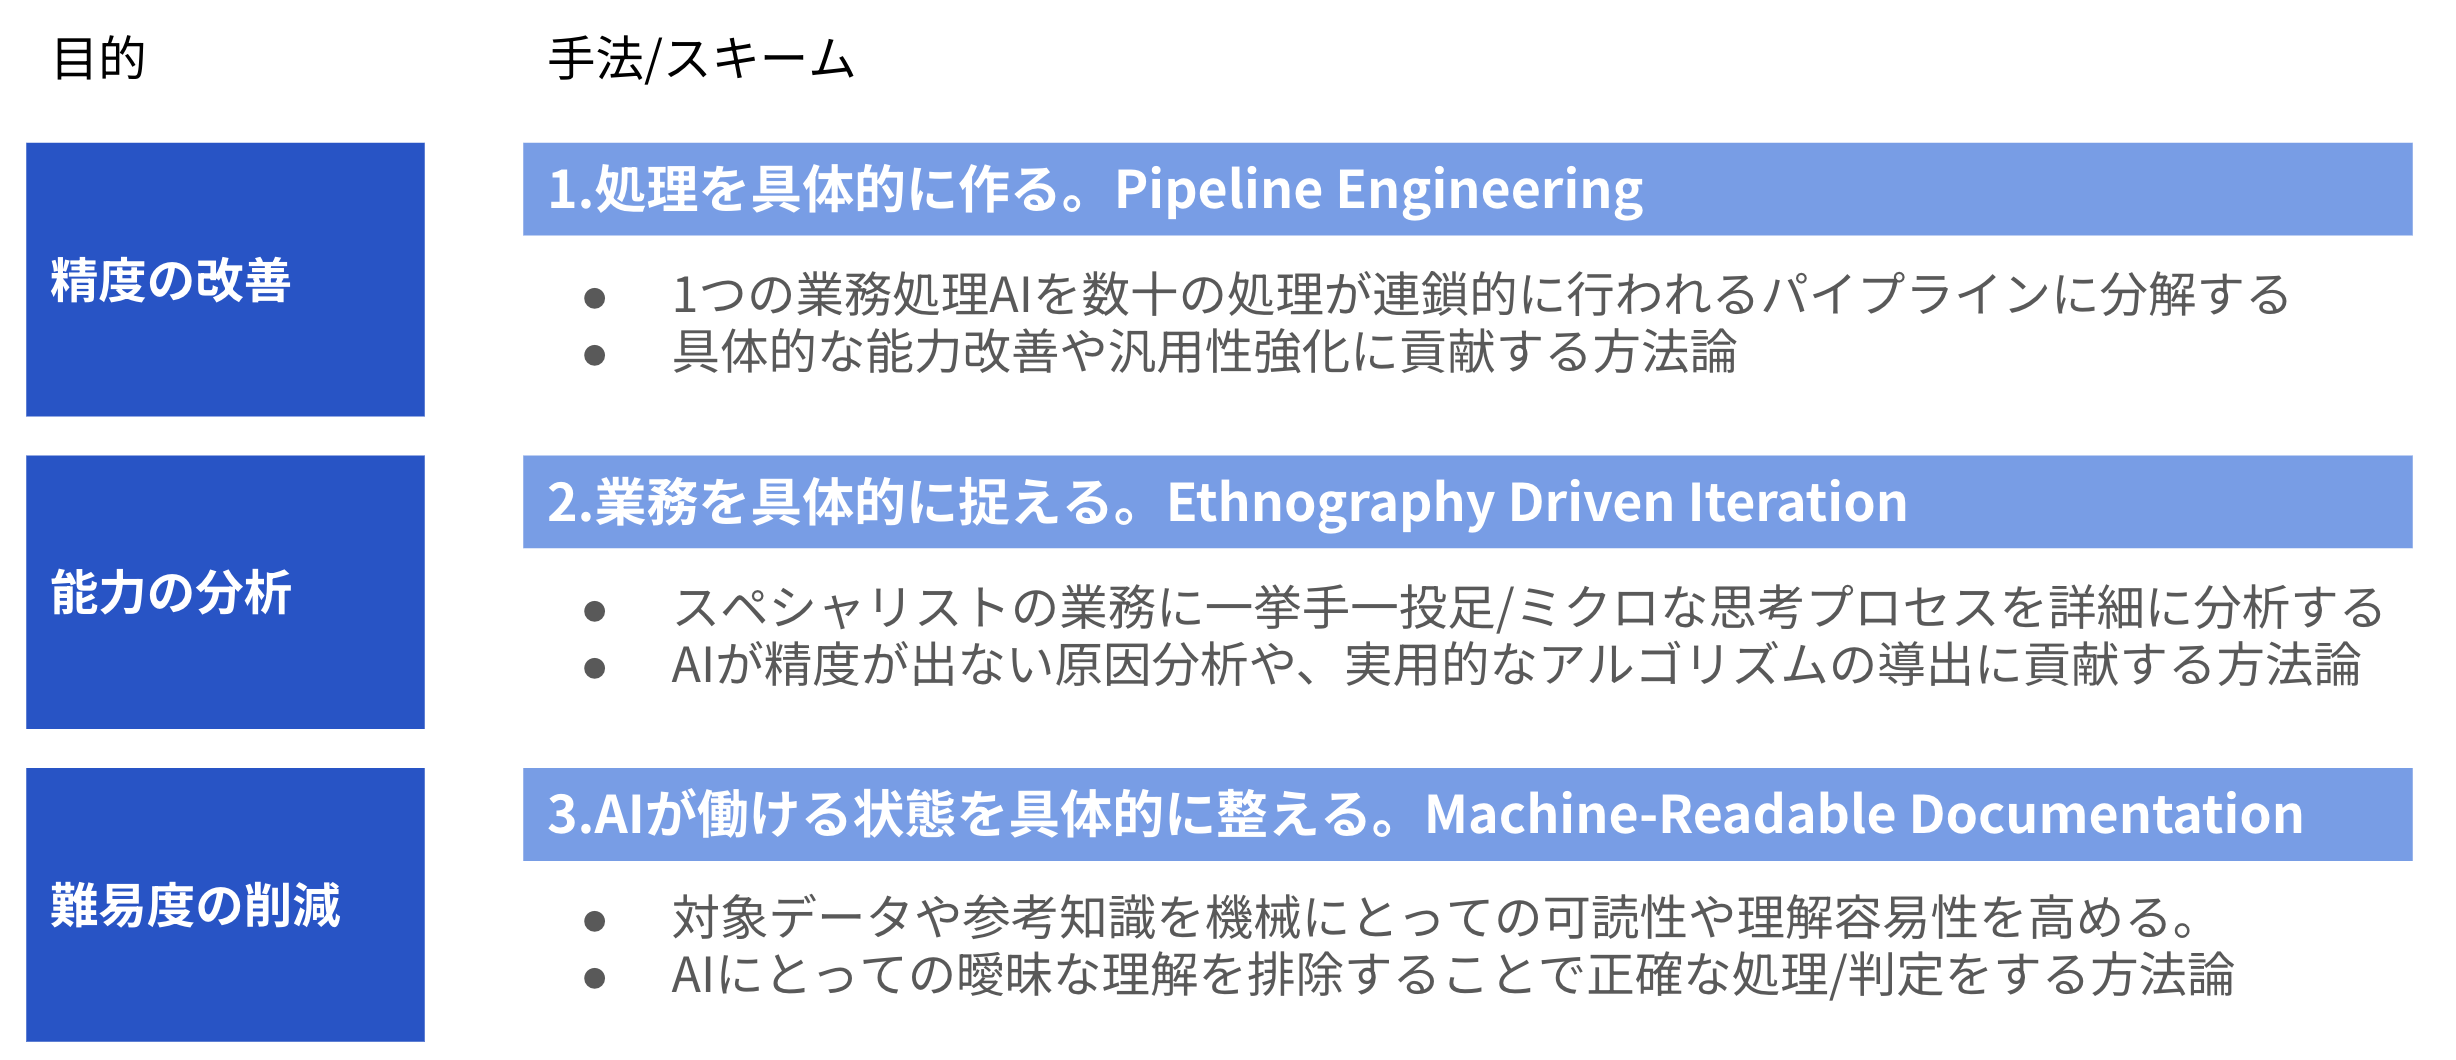
1.処理を具体的に作る。
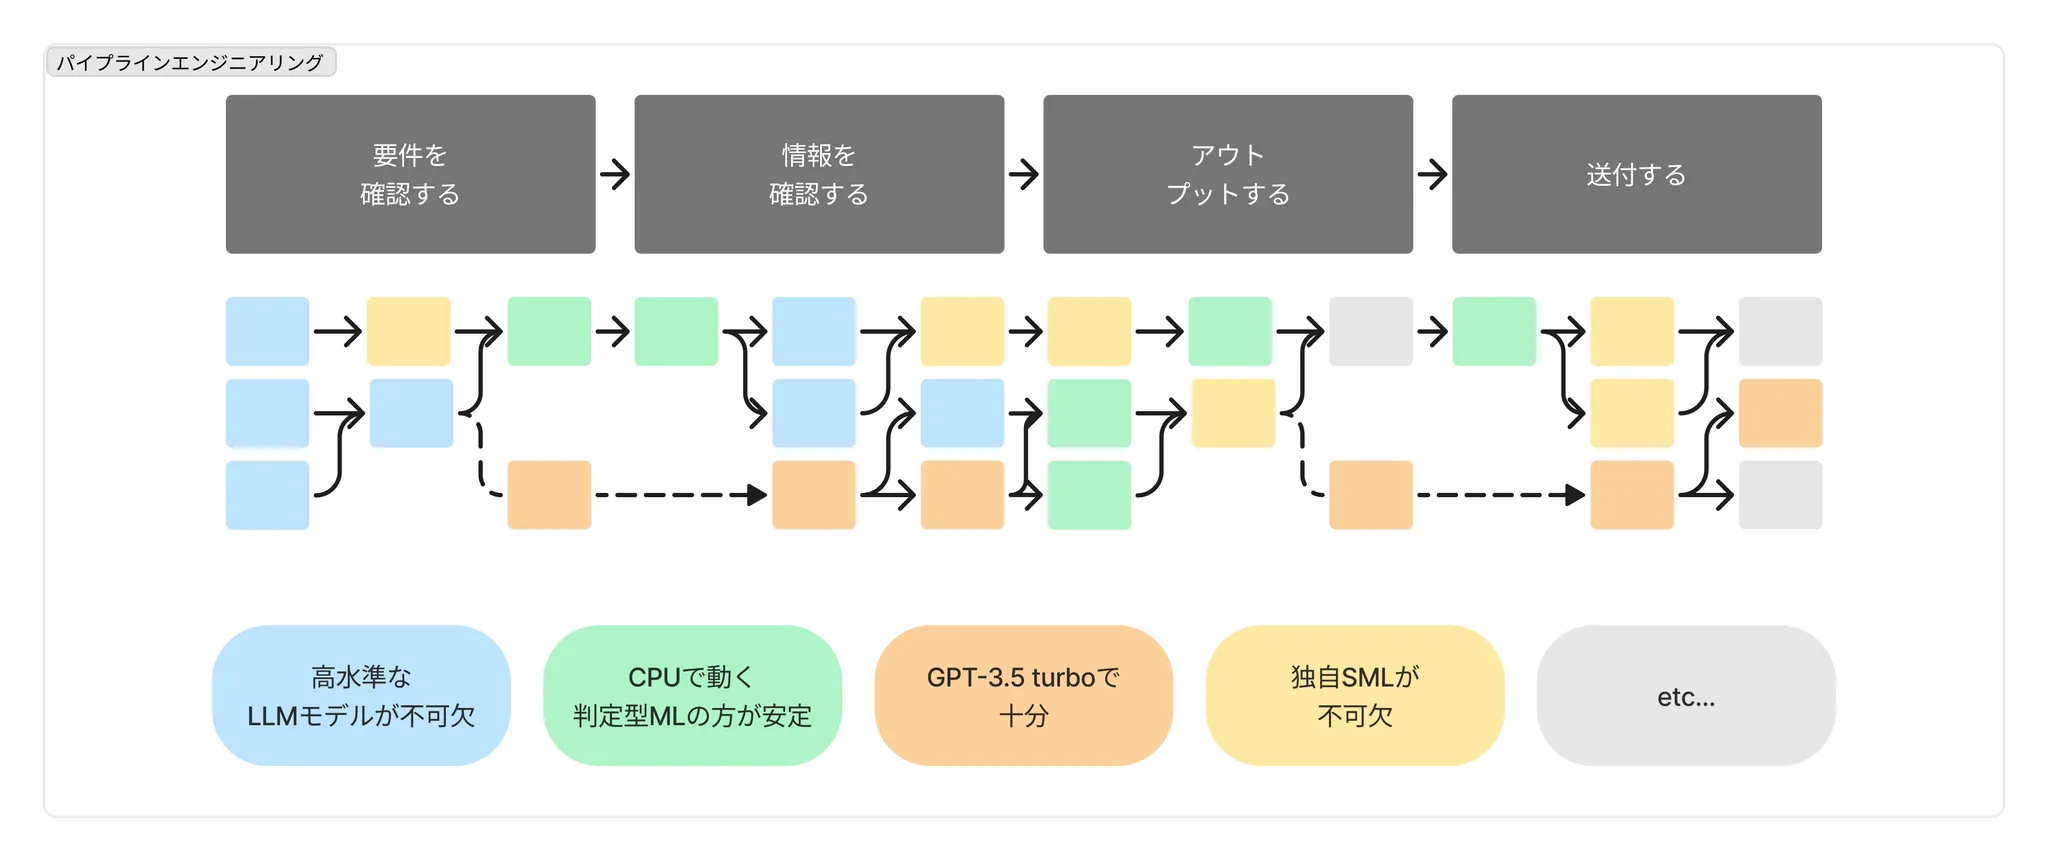
Pipeline Engineering
行動と結果
Action
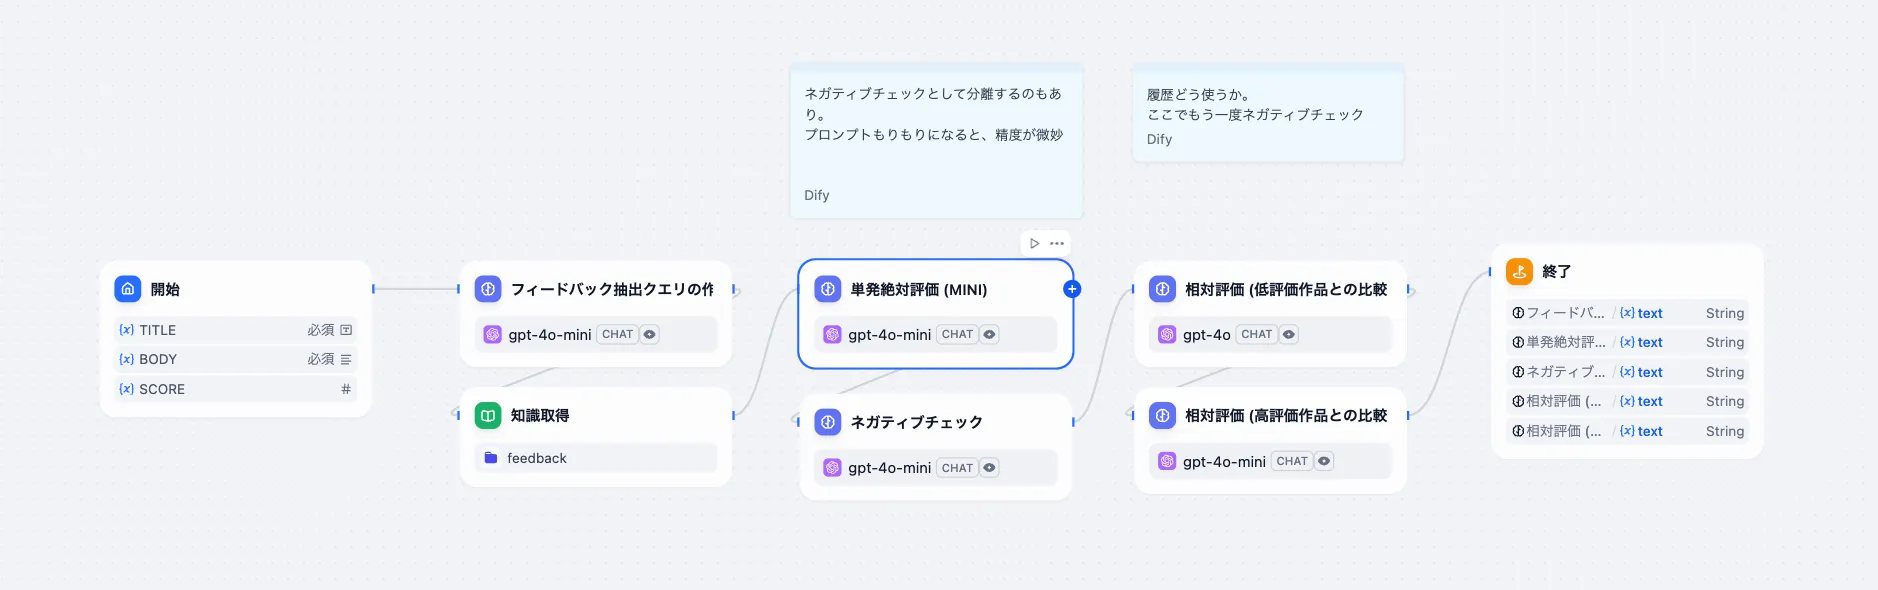
- 1つのプロンプトで数千文字。あの手この手でプロンプトチューニングをする。
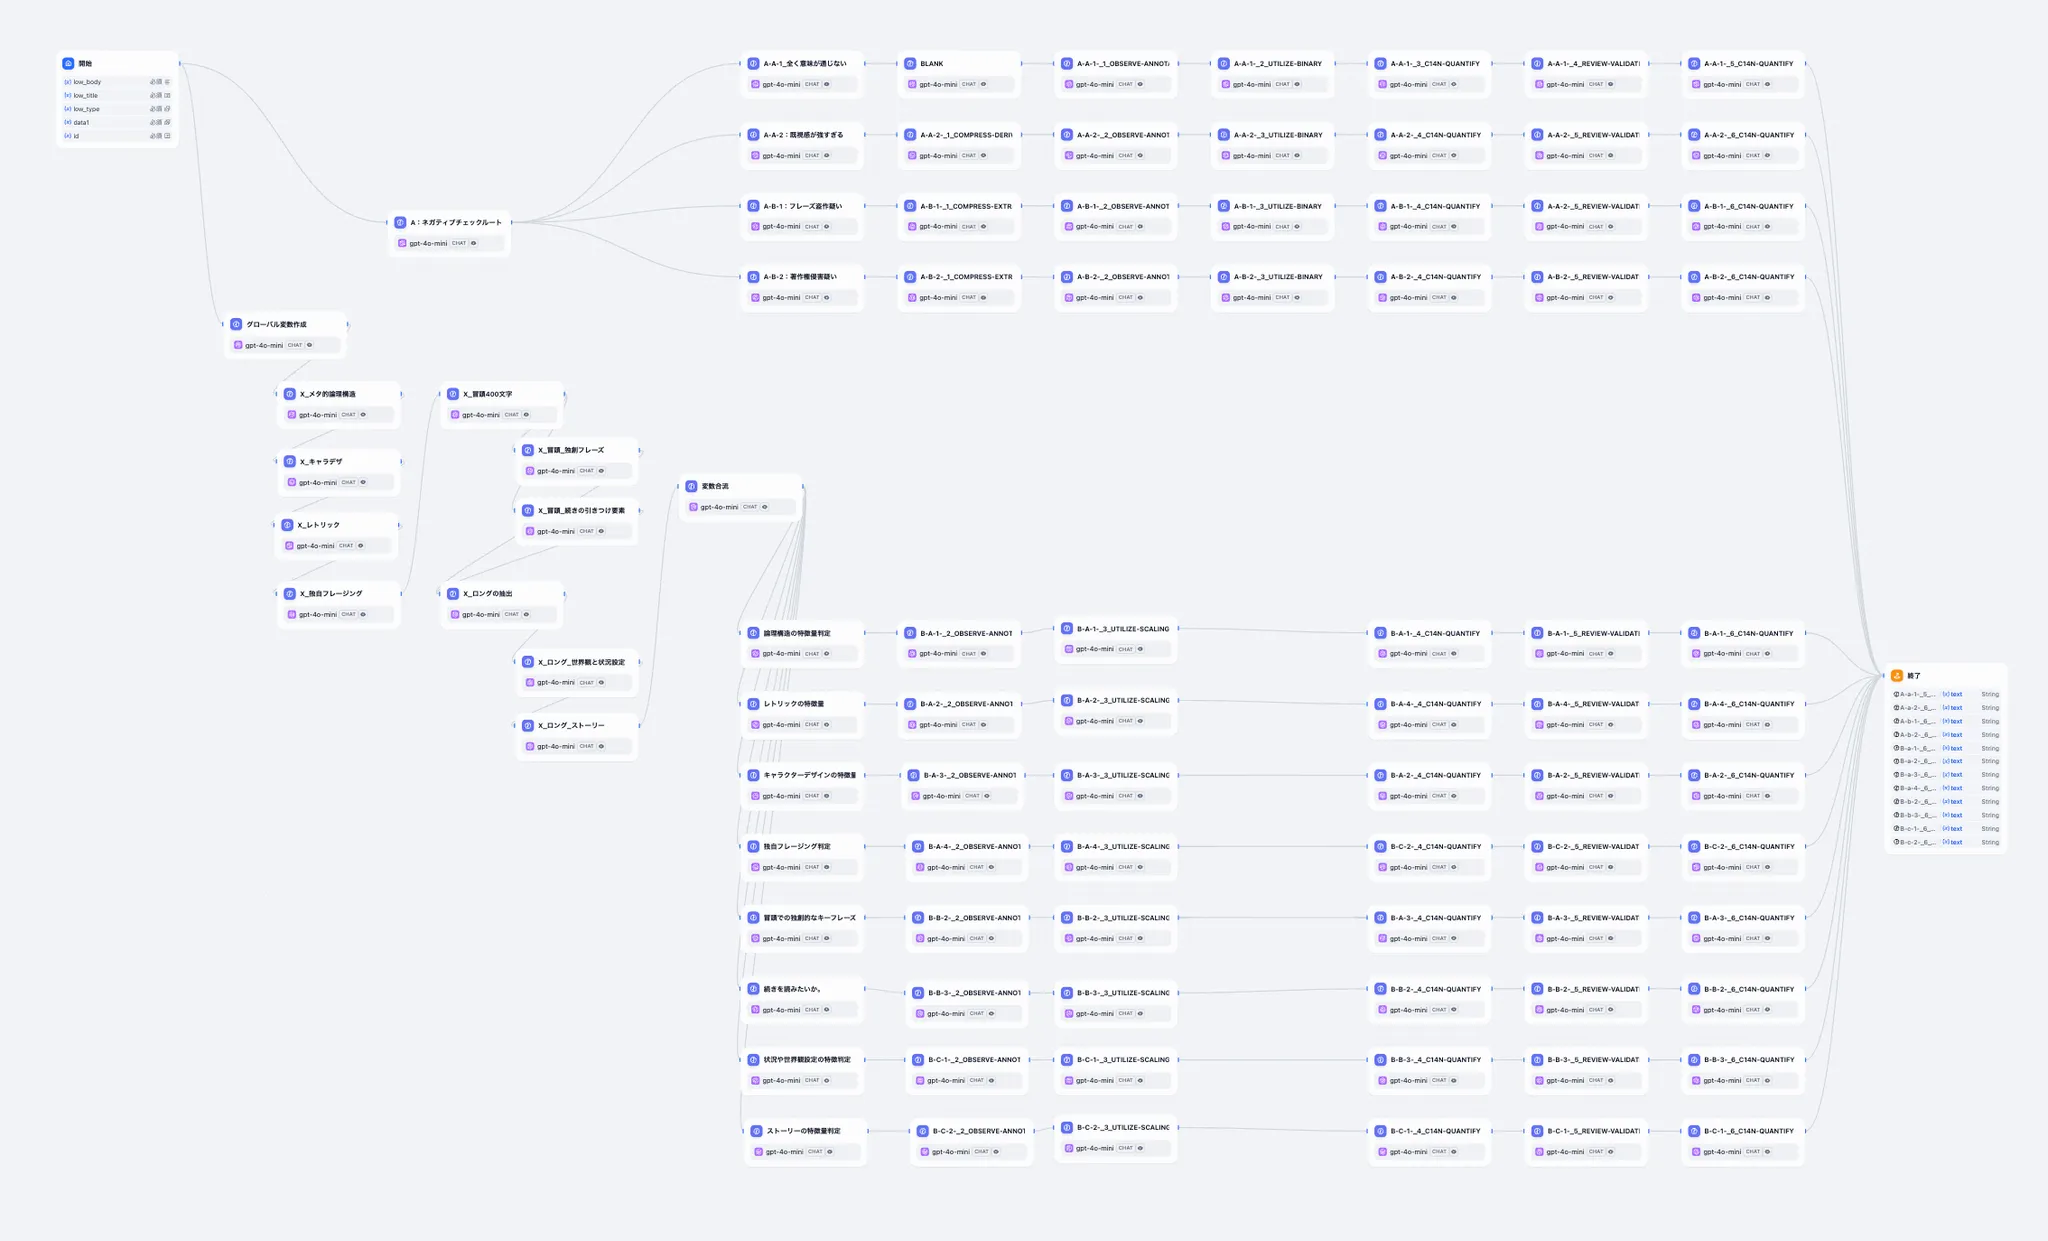
- ではなく、具体的に分解して構築する。
Before
After
Outcome
- 具体的に精度の欠損に影響を与えている要素が見えるように評価が可能になり、改善が積み重なった。
recallの精度65%→100%へと発展(n2000程の範囲)
- = 企業として良い記事や作品が、AIに誤って切り落とされることがない。
- accuracy
- 良い記事は良い、悪いものは悪いと言えた正解率
- recall
- 良い記事に対して「良い」と判定できた度合い
具体的なやり方
1ラインの処理例
-
この記事ってどういう構成か8段落でまとめて。
- → それを変数Xとする
-
Xってどういう具体的にどういうカテゴリーに分類されるかな?
- → Yとする
- Yな作品っていう目線で良い作品かどうかを評価すべきかな?
- → Yとする
- Yな作品っていう目線で良い作品かどうかを評価すべきかな?
- → Yとする
-
Xって小説における構成としてどんな特徴量がどれくらいあると言える?
- → 特徴Aがレベル3、特徴Bがレベル2….
- → Zとする
- → 特徴Aがレベル3、特徴Bがレベル2….
-
Xな論理構成、Yな目線で評価したいけど、Zな特徴の小説って良い?
- → 1~4で回答
-
これを×12ライン通過して生まれた要素を元に、「良い記事か?」の評価を作る。
- 分析処理45処理
- 1つあたり2000文字程度のプロンプトが含まれる処理
- 前処理、変数化12処理
- データ加工、抽出、変数化
- 曖昧性排除12処理
- 出力に対して形式の正規化や曖昧性排除を行うための処理12個
- 分析処理45処理
2.業務を具体的に捉える。
Ethnography Driven Iteration
行動と結果
Action
- 出版社で応募作品への審査をになっていた方などを数時間ほどインタビューを実施
- それを元にアルゴリズムを追加したり、再構築した。
Outcome
- 元々の判定処理の手前にフィルタリングできる処理ができた。
- そのため、フィルタ後の対象のみに対して、しっかりとした処理ができるように。
- そのため、精度や自動化率を上げやすくなった。
具体的なやり方
- ヒアリングをするだけではなく、実際に作品のテキストを読み評価する行為を目の前でしてもらう。
- 頭の中での思考もぶつぶつと喋ってもらいながら観察と分析を行う。
- 例
(冒頭を読んでいる)「ん〜あんまり文章を書くのは得意ではなさそうだなぁ〜」
- senko:なんでそう思いました?
- senko:どの文字やどの行で思ったんですか?
- senko:そこまでの情報でなぜ判断できたんですか?
- senko:その判断はどう言った経験からできるようになっていますか?
- senko:その判断をその時点で行ったあとはどこを読むようにしているのですか?
- senko:これはどう言った作品でも応用している考え方ですか?
この対話は何をしているのか?の解説
senko:なんでそう思いました?
- **評価を行う上でのドメイン知識の確認**
- senko:どの文字やどの行で思ったんですか?
- **AI処理に変換する場合のシステマチックな対象文章特定ができるかの確認**
- senko:そこまでの情報でなぜ判断できたんですか?
- **評価を行う上での必要なデータ内容の特定**
- senko:その判断はどう言った経験からできるようになっていますか?
- **学習やRAGとして渡すべき参考情報の特定**
- senko:その判断をその時点で行ったあとはどこを読むようにしているのですか?
- **このフラグが立った処理において、他とは異なるアルゴリズムの必要性の確認**
- senko:これはどう言った作品でも応用している考え方ですか?
- **抽出している推論プロセスの汎用性の仮説構築**
3.AIが働ける状態を具体的に整える。
Machine-Readable Documentation
行動と結果
Action
- 改善を進める中で、読んでて読むのをやめてしまいうるような「冗長な作品」を特定できなかった。
- なので、1記事として扱わずに、1記事を250ほどに分解して行番号を付与して処理。
Outcome
- 冗長判定での足切りが成立。
- より長文な作品における厳密なスコアリングが行えるようになった。
具体的なやり方
- 冗長性判定のための前処理
- 要素番号の付与
- 例
- 読点の出現または、2回改行がある部分で区切りをつける。
- 上から要素番号を割り当てる。1,2,3,4,5……253 など
- 例
- 要素番号の付与
- 要素単位の冗長スコア
- 要素番号の連続する要素同士の関係性を評価
- 全ての前後関係に処理を実施
- 総合判断
- 連続して冗長フラグがN個続いたら冗長と評価
小まとめ
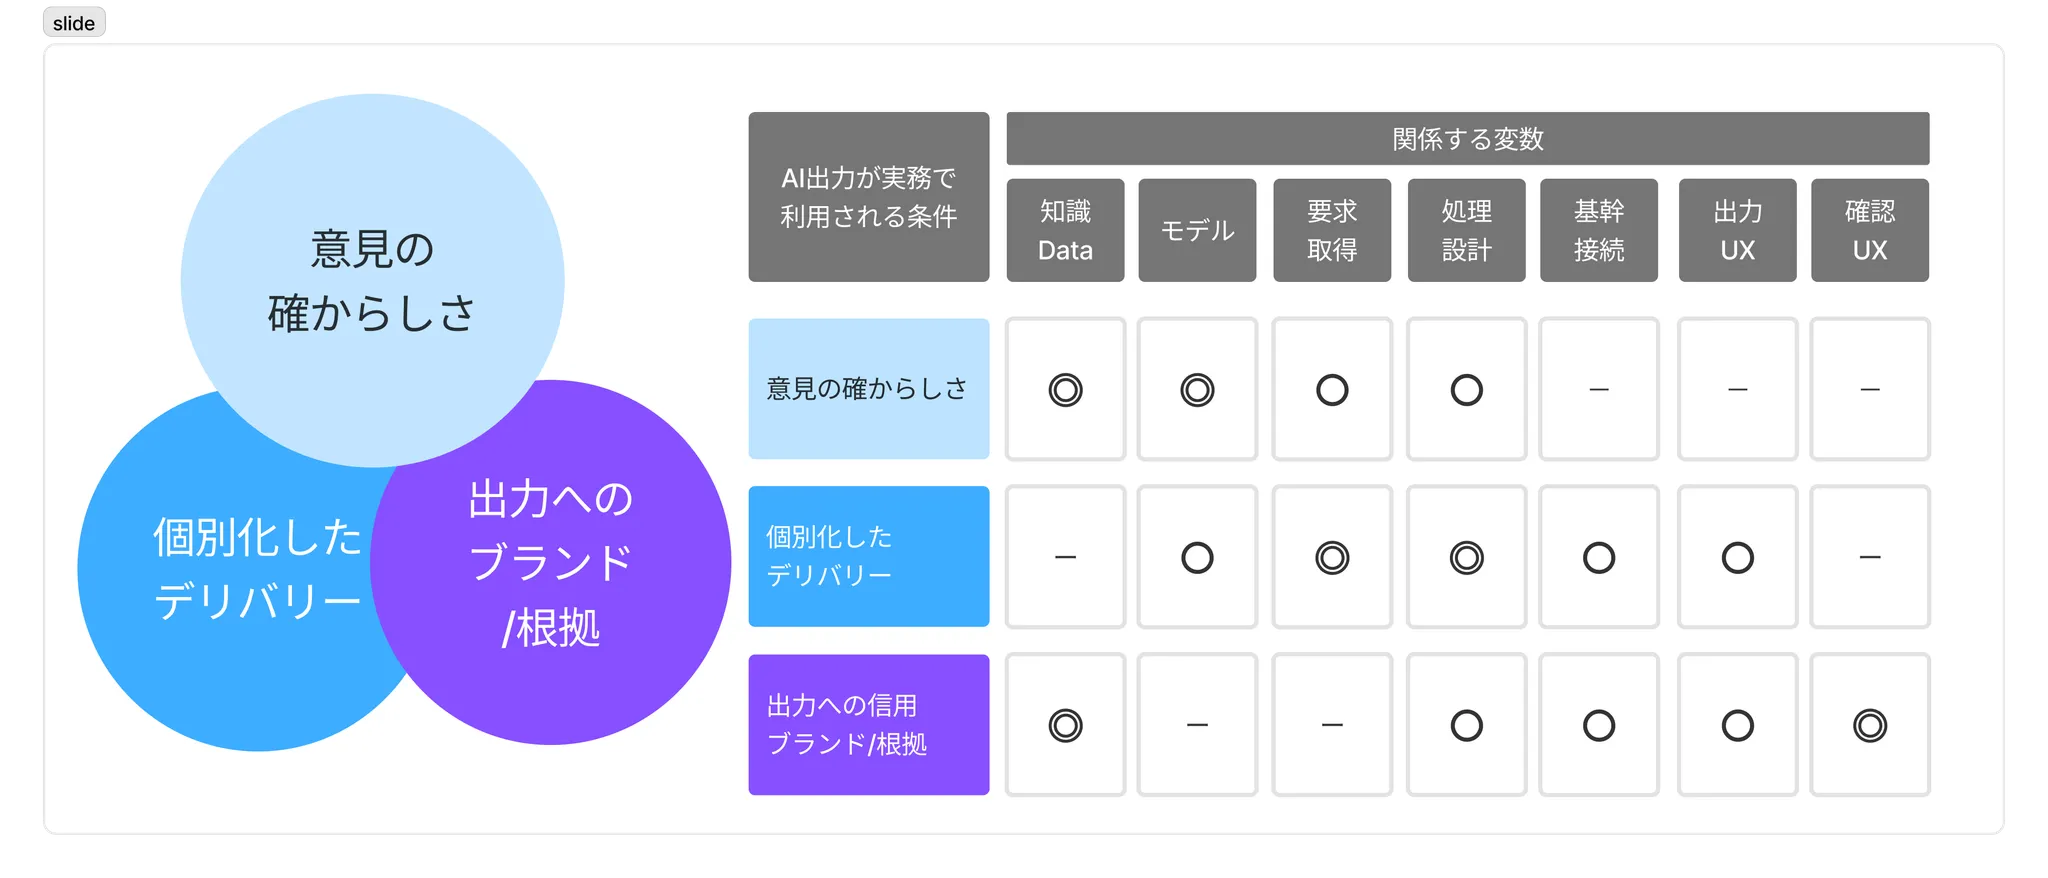
1. AIはとっても賢いが、曖昧に仕事ができてしまう。
だから、処理
過程の確認と改善ができるような ”信用可能な構築方法” が必要
- AIの出力を人が信用するための前提条件
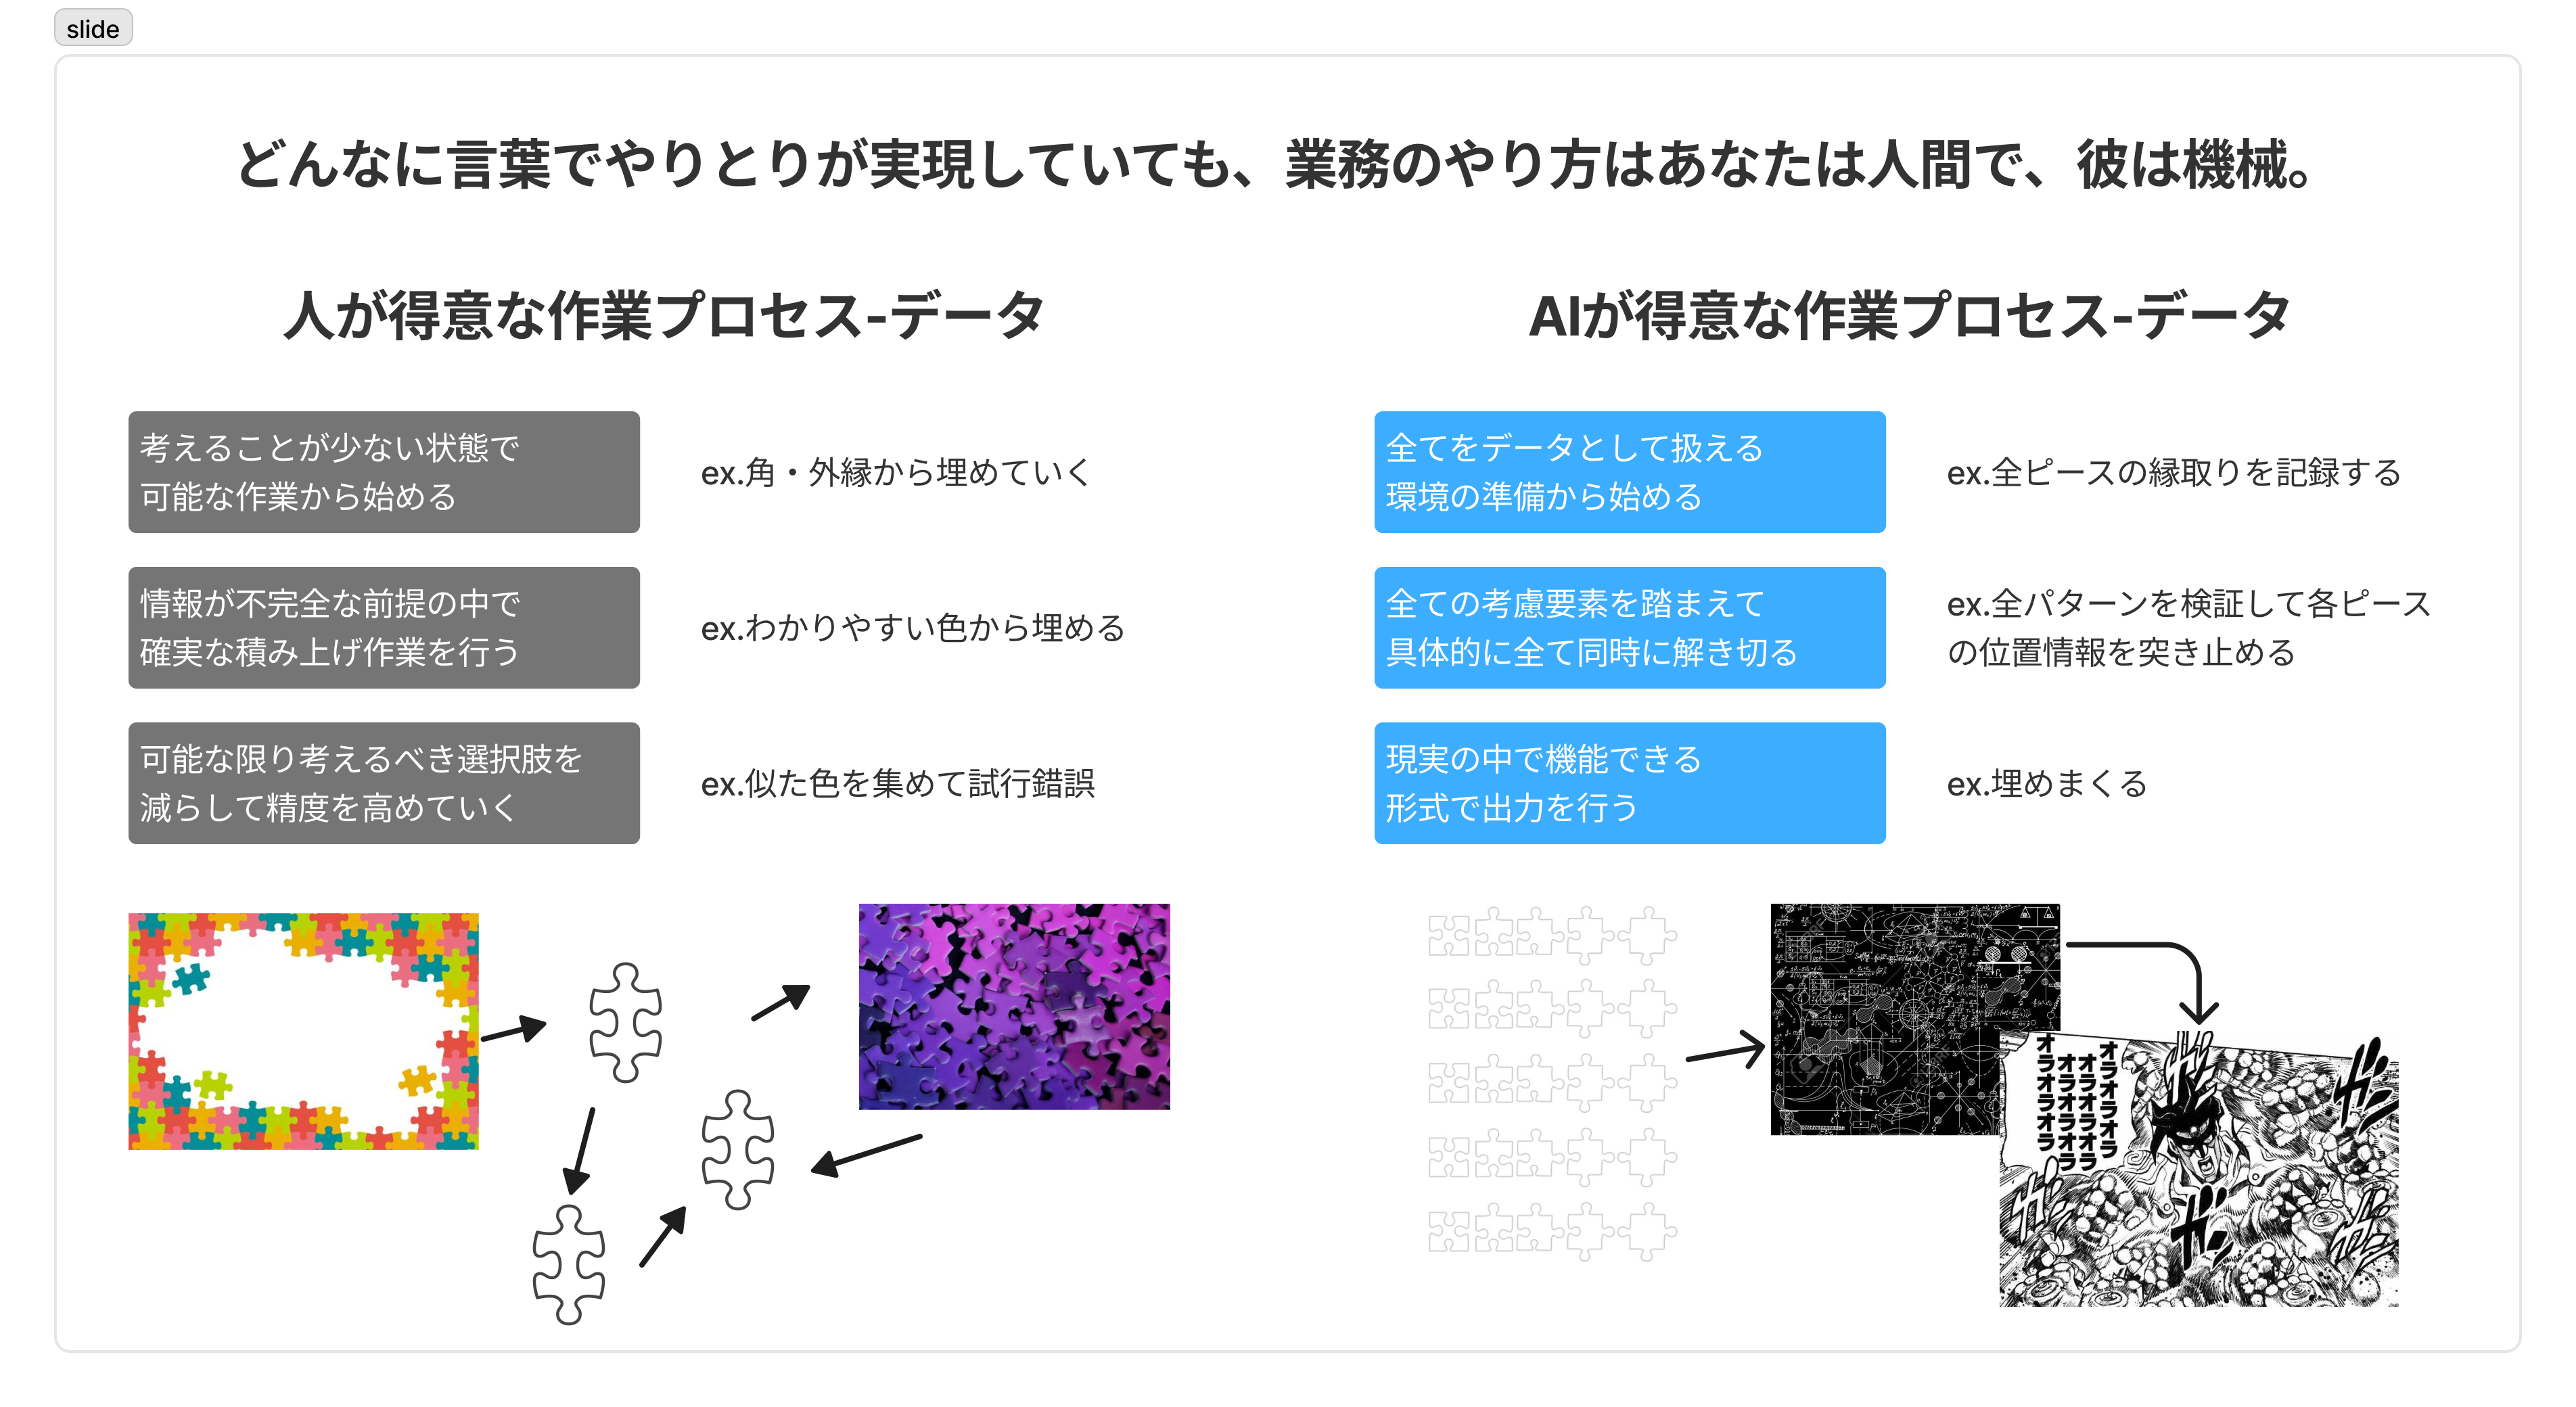
2.人はとっても賢いが、本人も無自覚な業務プロセスが大量に存在する。
だから、
暗黙的な思考プロセスまで確認する ”業務の科学” が必要
3.AIは同時並列で高速に処理ができる。
だから、
人としては遠回りでも ”AIが働ける環境の手配” が必要
大まとめ
LTテーマ:「どんなチームがAIで成果を出すのか?」
“人とAIの苦手を具体的にカバーできるチーム” ではないか。
業務の科学、データの整理、アルゴリズムの構築、利用体験の構築、が成果を生み出す。